
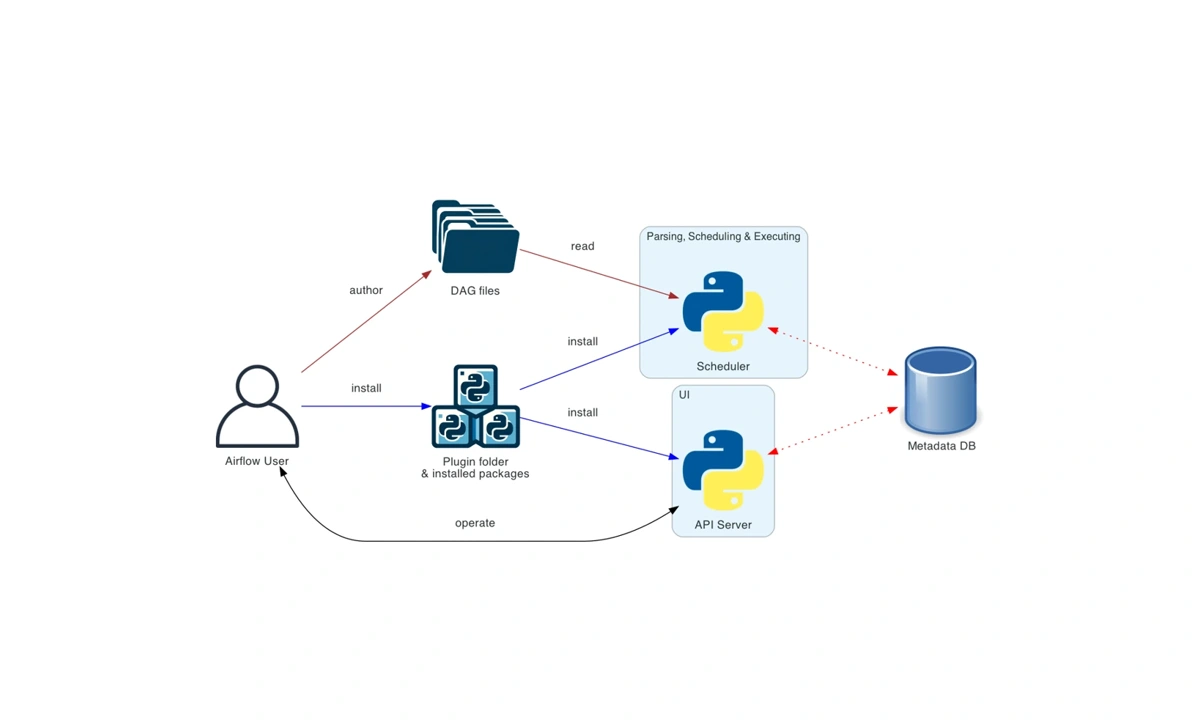
گردش کار با اجرای یک اسکریپت فرق دارد
Apache Airflow برای تعریف و هماهنگ کردن گردش کارها به کار می رود. واحد اصلی توصیف کار یک گراف جهت دار بدون چرخه یا DAG است که وظیفه ها و وابستگی آن ها را نشان می دهد. اما ارزش این مدل فقط رسم چند پیکان نیست. هر اجرای واقعی وضعیت، زمان، تلاش های دوباره و ورودی مشخصی دارد. اگر این تفاوت ها در طراحی نادیده گرفته شوند، یک گردش کار ظاهراً موفق می تواند داده تکراری، گزارش ناقص یا خروجی مربوط به روز اشتباه تولید کند. فهمیدن معنای اجرا پیش از تنظیم زمان بندی ضروری است.
فرض کنید هر روز باید فایل فروش دریافت شود، کیفیت داده بررسی گردد، جدول تحلیلی به روز شود و گزارش منتشر شود. این چهار مرحله صرفاً ترتیب زمانی ندارند؛ قرارداد داده نیز میان آن ها وجود دارد. گزارش نباید روی جدولی که هنوز کامل نشده منتشر شود و بارگذاری نباید فایل نامعتبر را بپذیرد. Airflow امکان بیان وابستگی را فراهم می کند، ولی اینکه موفقیت هر مرحله دقیقاً چه معنایی دارد بر عهده طراح است. خروج بدون خطای فرایند همیشه معادل موفقیت تجاری نیست.
DAG، Dag Run و Task Instance
تعریف DAG شبیه نقشه کار است. Dag Run اجرای مشخصی از آن نقشه را نشان می دهد و Task Instance وضعیت یک وظیفه در همان اجرای مشخص است. یک وظیفه با نام ثابت می تواند در چند اجرای روزانه وضعیت متفاوت داشته باشد. این تفکیک هنگام بازپردازش مهم می شود: اجرای مجدد داده دوشنبه نباید به طور مبهم وضعیت سه شنبه را تغییر دهد. شناسه اجرا و محدوده داده باید در log، نام خروجی و کنترل های صحت قابل مشاهده باشند.
برای نمونه فروش، نام وظیفه بارگذاری ثابت است، اما خروجی آن باید به دوره پردازش مربوط باشد. اگر همه اجراها به یک مسیر ثابت فایل موقت بنویسند، دو اجرای هم زمان ممکن است کار یکدیگر را خراب کنند. مسیرهایی با شناسه اجرا یا پارتیشن مشخص، این برخورد را کاهش می دهند. البته تکثیر مسیر کافی نیست؛ مرحله انتشار نیز باید بداند کدام خروجی معتبر و نهایی است. بهتر است تولید داده و اعلام آماده بودن آن دو مرحله با قرارداد روشن باشند.
زمان واقعی و زمان منطقی
زمانی که worker شروع به کار می کند لزوماً زمانی نیست که داده باید نمایندگی کند. یک اجرای مربوط به دیروز ممکن است امروز به علت تأخیر منبع آغاز شود. همچنین معنای logical date و data interval به timetable و نسخه Airflow وابسته است. نباید بدون بررسی فرض کرد هر cron روزانه همیشه یک بازه کامل روز قبل می سازد. در نسخه ها و حالت های مختلف، جدول زمانی می تواند بر لحظه trigger یا بازه داده تأکید متفاوتی داشته باشد.
راه مطمئن این است که قرارداد زمانی را با چند نمونه واقعی بنویسید: اجرای اول چه زمانی ساخته می شود، ورودی آن کدام بازه است و در شروع دستی چه مقادیری دریافت می کند؟ سپس این نمونه ها را در محیط آزمایش بررسی کنید. اگر داده بر اساس منطقه زمانی کسب و کار گزارش می شود، تبدیل آن به UTC باید آگاهانه باشد. تغییر ساعت فصلی یا روزهای با طول متفاوت را نیز در صورت ارتباط با منطقه زمانی در آزمون بگنجانید. نام «روزانه» جای تعریف مرز روز را نمی گیرد.
catchup و backfill دو تصمیم عملیاتی
وقتی گردش کار مدتی غیرفعال بوده است، باید تصمیم بگیرید اجراهای از دست رفته تولید شوند یا فقط اجرای جاری انجام شود. همچنین ممکن است بخواهید با منطق جدید یک دوره تاریخی را دوباره پردازش کنید. این نیازها با catchup و backfill مرتبط اند، اما هر کدام باید با ظرفیت منبع و مقصد هماهنگ شوند. ساخت ناگهانی صدها اجرا ممکن است پایگاه داده مبدأ یا API بیرونی را تحت فشار بگذارد، حتی اگر خود Airflow منابع کافی داشته باشد.
برای بازپردازش سه ماه فروش، نخست دامنه و نسخه منطق را مشخص کنید. سپس نرخ اجرا و تعداد هم زمان را محدود کنید و نتیجه چند روز نمونه را بررسی کنید. آیا قیمت یا نرخ تبدیل باید بر اساس داده تاریخی همان روز باشد یا وضعیت فعلی؟ اگر وظیفه هنگام اجرا فقط مقدار امروز را از API بگیرد، بازپردازش تاریخی ممکن است معنای گزارش را تغییر دهد. قابلیت اجرای دوباره زمانی ارزشمند است که وابستگی های زمانی داده نیز قابل بازسازی باشند.
وظیفه باید در برابر تکرار مقاوم باشد
شکست شبکه ممکن است پس از ثبت داده رخ دهد و worker از موفقیت مقصد خبر نداشته باشد. در تلاش بعدی، همان عملیات دوباره اجرا می شود. اگر هر اجرا صرفاً ردیف های جدید اضافه کند، نتیجه تکراری خواهد شد. طراحی idempotent یعنی تکرار یک واحد منطقی کار، اثر نامطلوب اضافی ایجاد نکند. این ویژگی از تنظیم retries به دست نمی آید؛ باید در شیوه نوشتن خروجی، کلیدها و قرارداد مقصد ساخته شود.
در نمونه روزانه، می توان خروجی را برای یک پارتیشن مشخص تولید و پس از بررسی جایگزین کرد، یا از کلید یکتای رکورد و عملیات مناسب مقصد استفاده کرد. انتخاب به پایگاه داده و نیاز تجاری بستگی دارد. آزمون لازم ساده است: یک وظیفه را پس از ثبت بخشی از کار متوقف کنید و دوباره اجرا کنید. سپس تعداد، جمع مبلغ و کلیدهای تکراری را بررسی کنید. موفق شدن تلاش دوم بدون این بررسی ها، سالم بودن نتیجه را ثابت نمی کند.
وابستگی کنترل با انتقال داده یکی نیست
پیکان میان دو وظیفه می گوید اجرای مرحله بعد به شرطی وابسته است، اما خود آن پیکان داده بزرگ را منتقل نمی کند. برای داده حجیم، معمولاً بهتر است فایل یا جدول در یک محل مشترک قابل اعتماد تولید شود و فقط شناسه یا مسیر آن میان مراحل رد و بدل شود. استفاده از سازوکار ارتباطی کوچک مانند XCom برای انبوه داده می تواند پایگاه متادیتا را سنگین کند و عیب یابی را دشوار سازد. ظرفیت و backend آن باید با مستندات نسخه بررسی شود.
قرارداد خروجی می تواند شامل مسیر، schema، تعداد ردیف و شناسه checksum باشد. مرحله بعد پیش از مصرف، آماده بودن خروجی و نسخه قرارداد را کنترل می کند. این طراحی به ویژه وقتی وظیفه ها روی worker های مختلف اجرا می شوند مهم است؛ فایل محلی یک worker لزوماً روی دیگری وجود ندارد. در محیط آزمایشی عمداً مراحل را روی ماشین های جدا اجرا کنید تا وابستگی پنهان به دیسک محلی آشکار شود. موفقیت روی لپ تاپ واحد برای استقرار توزیع شده شاهد کافی نیست.
موفقیت DAG را درست تعریف کنیم
وضعیت نهایی گردش کار از وضعیت وظیفه ها و قواعد اجرای آن ها تأثیر می گیرد. یک وظیفه پاک سازی که پس از هر حالت اجرا می شود نباید باعث شود شکست مرحله اصلی در گزارش عملیاتی گم شود. هنگام استفاده از trigger rule های متفاوت، مسیرهای شکست و skipped را صریح بررسی کنید. هدف این نیست که همه خانه های رابط سبز شوند؛ هدف این است که وضعیت نهایی با نتیجه مورد انتظار کسب و کار تطابق داشته باشد.
یک تمرین مفید رسم سه سناریو است: موفقیت کامل، شکست کنترل کیفیت و شکست انتشار پس از بارگذاری موفق. برای هر سناریو تعیین کنید چه چیزی باید دوباره اجرا شود و چه چیزی نباید تکرار شود. اگر گزارش ارسال شده ولی ثبت وضعیت آن شکست خورده باشد، اجرای مجدد کورکورانه ممکن است پیام تکراری بفرستد. بهتر است اثرهای بیرونی با شناسه و وضعیت قابل پیگیری طراحی شوند. مشاهده پذیری باید بین «وظیفه تمام شد» و «اثر مورد انتظار تأیید شد» تفاوت بگذارد.
ظرفیت را در مرز سیستم های وابسته بسنجیم
افزودن worker بیشتر می تواند زمان انتظار را کاهش دهد، اما ممکن است هم زمان فشار روی یک منبع محدود را بیشتر کند. اگر همه وظیفه ها به یک API با سقف درخواست وصل شوند، افزایش هم زمانی نتیجه معکوس می دهد. pool ها و محدودیت های اجرا برای بیان چنین مرزهایی مفید اند. به جای یک عدد هم زمانی عمومی، منابع واقعی را دسته بندی کنید: پایگاه داده فروش، سرویس تبدیل فایل و سامانه ارسال گزارش ممکن است سقف های متفاوت داشته باشند.
در آزمون بار، زمان صف و زمان اجرای واقعی را جدا ببینید. زمان صف بالا با اجرای سریع نشانه متفاوتی از اجرای کند در همه worker هاست. همچنین retry های هم زمان می توانند موج دوم فشار بسازند. تأخیر مناسب و سیاست تلاش دوباره باید با رفتار سرویس وابسته هماهنگ باشد. اگر منبع برای یک ساعت از دسترس خارج شده، هزاران تلاش کوتاه پشت سر هم ارزشی ندارد. پیام خطا باید علت و دوره داده متاثر را روشن کند تا پاسخ عملیاتی هدفمند باشد.
کد تعریف گردش کار هم هزینه دارد
فایل DAG فقط هنگام اجرای یک وظیفه خوانده نمی شود؛ سامانه برای کشف و پردازش تعریف ها نیز با آن کار می کند. قرار دادن عملیات سنگین، تماس شبکه یا خواندن حجیم در سطح بالای فایل می تواند پردازش تعریف ها را کند و شکننده کند. بهتر است تعریف گراف تا حد امکان سبک و قابل پیش بینی باشد و کار واقعی در مرحله اجرای وظیفه انجام شود. این جداسازی همچنین آزمون و فهم وابستگی ها را آسان تر می کند.
برای تیمی با تعداد زیاد گردش کار، قرارداد نام گذاری و مالکیت اهمیت پیدا می کند. هر DAG باید صاحب پاسخ گو، شرح ورودی و خروجی و مسیر رسیدگی به شکست داشته باشد. اگر کارمند اصلی در دسترس نباشد، فرد دیگری باید بتواند بفهمد یک اجرای عقب افتاده چه اثر تجاری دارد. توضیح کوتاه و دقیق در کنار کد از ده ها تنظیم بدون زمینه مفیدتر است. مستندات باید همراه تغییر منطق یا زمان بندی به روز شوند، نه پس از رخداد نخست.
انتشار و بازگشت را با داده هماهنگ کنیم
تغییر کد یک DAG ممکن است بر اجراهای آینده و بازپردازش گذشته اثر بگذارد. پیش از انتشار، مشخص کنید اجراهای در حال انجام با کدام نسخه کار می کنند و چه خروجی هایی قابل ترکیب هستند. برای تغییر schema، تولید کننده و مصرف کننده باید مسیر سازگاری داشته باشند. بازگرداندن کد قدیمی لزوماً داده نوشته شده با schema جدید را برنمی گرداند. بنابراین برنامه rollback باید اثر داده را هم توضیح دهد، نه فقط نحوه بازگشت commit را.
Airflow زمانی ارزش واقعی دارد که زمان، وابستگی و نتیجه هر اجرا قابل توضیح باشد. از یک گردش کار کوچک با داده ساختگی شروع کنید، شکست های مهم را وارد کنید و رفتار retry و backfill را ببینید. وقتی خروجی تکرارپذیر، مرز انتشار روشن و وضعیت نهایی معنادار شد، افزایش مقیاس آسان تر خواهد بود. یک DAG خوب صرفاً گرافی مرتب نیست؛ قراردادی اجرایی میان داده، زمان و مسئولیت تیم هاست که در روزهای خرابی نیز قابل اتکا باقی می ماند.


