
یک فایل ستونی چگونه خواندن را کم می کند؟
Apache Parquet قالبی برای ذخیره داده ستونی است که در گردش کارهای تحلیلی فراوان استفاده می شود. مزیت آن را نباید فقط با کوچک تر شدن فایل توضیح داد. سازمان داخلی فایل به خواننده کمک می کند ستون های لازم و در برخی شرایط بخش های مرتبط داده را بخواند. برای بهره بردن از این قابلیت، باید تفاوت فایل، row group، column chunk و page را فهمید. انتخاب اندازه ها و ترتیب داده بدون شناخت query واقعی می تواند نتیجه ای متفاوت از انتظار ایجاد کند.
فرض کنید فایل رخداد یک سامانه شامل پنجاه ستون است، اما گزارش روزانه فقط زمان، نام سرویس و کد نتیجه را لازم دارد. در یک قالب ردیفی ساده ممکن است پردازش ناچار باشد از میان اطلاعات فراوانی عبور کند که به پرسش مربوط نیستند. ذخیره ستونی امکان می دهد داده ستون های مورد نیاز جداگانه خوانده شود. البته میزان صرفه جویی به موتور خواننده، ساختار فایل و الگوی دسترسی وابسته است. پسوند parquet به تنهایی تضمین نمی کند هر query سریع یا کم هزینه خواهد بود.
row group مرز افقی داده است
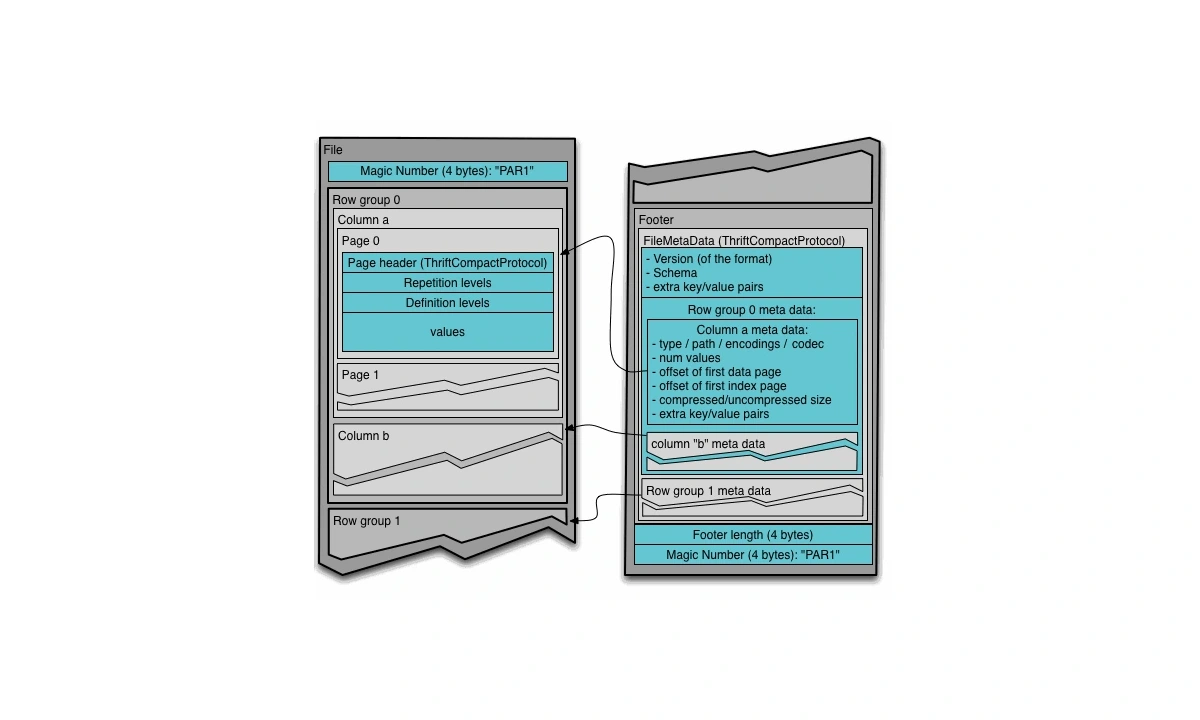
یک فایل Parquet از گروه هایی از ردیف ها تشکیل می شود. هر row group مجموعه ای از ردیف ها را پوشش می دهد و برای هر ستون، بخش مربوط به آن گروه را نگه می دارد. بنابراین قالب هم تقسیم افقی دارد و هم سازمان ستونی. این ساختار امکان می دهد خواننده بخشی از فایل را به عنوان واحد کار در نظر بگیرد. اندازه گروه بر حافظه هنگام نوشتن، موازی سازی و مقدار داده ای که ممکن است برای یک پرسش خوانده شود اثر می گذارد.
گروه بسیار بزرگ می تواند برای برخی اسکن های گسترده مناسب باشد، اما ممکن است حافظه نویسنده و حداقل کار یک خواننده را بالا ببرد. گروه بسیار کوچک نیز سربار متادیتا و تعداد واحدهای پردازش را افزایش می دهد. هیچ اندازه واحدی برای همه داده ها و همه موتورهای query بهترین نیست. برای تصمیم، اندازه ردیف و نوع ستون ها را هم در نظر بگیرید. یک میلیون ردیف با چند عدد کوچک با همان تعداد ردیف دارای متن طولانی، نیاز یکسانی ندارد.
column chunk و page
درون هر row group، داده یک ستون در column chunk مربوط قرار می گیرد و این بخش به page ها تقسیم می شود. این لایه ها به رمزگذاری، فشرده سازی و خواندن داده شکل می دهند. لازم نیست کاربر روزمره همه جزئیات باینری را حفظ کند، اما دانستن مرزها در عیب یابی مفید است. اگر یک فایل بزرگ تنها واحد موازی سازی فرض شود، ممکن است قابلیت های واقعی موتور نادیده گرفته شوند. در مقابل، فرض موازی سازی نامحدود نیز بدون بررسی پشتیبانی خواننده درست نیست.
برای آموزش تیم، یک فایل کوچک با چند row group بسازید و متادیتای آن را با ابزار معتبر مشاهده کنید. تعداد گروه ها، اندازه فشرده و غیرفشرده ستون ها و نوع encoding را مقایسه کنید. سپس همان داده را با ترتیب متفاوت بنویسید. این تجربه نشان می دهد اندازه فایل فقط تابع تعداد ردیف نیست. توزیع مقادیر و شباهت داده های نزدیک به هم نیز اثر دارند. هدف آزمایش درک رابطه ساختار و هزینه است، نه پیدا کردن یک تنظیم جادویی برای همه فایل ها.
footer نقشه فایل را نگه می دارد
متادیتای انتهای فایل اطلاعات لازم برای شناخت ساختار و محل بخش های داده را فراهم می کند. خواننده می تواند بر اساس آن تصمیم بگیرد چه بخش هایی را بخواند. در ذخیره سازی راه دور، پشتیبانی از درخواست محدوده بایت و رفتار موتور روی تعداد درخواست ها اثر دارد. بنابراین هزینه خواندن فقط حجم انتقال نیست؛ تعداد round trip ها و درخواست های storage نیز می توانند مهم باشند. این موضوع برای تعداد بسیار زیاد فایل کوچک بیشتر دیده می شود.
از نظر عملی، کامل شدن فایل اهمیت دارد. فایلی که فرایند نویسنده پیش از پایان مناسب آن قطع شده، ممکن است footer معتبر نداشته باشد و قابل استفاده نباشد. بهتر است خروجی ابتدا در محل موقت یا با نام اجرای مشخص تولید شود و فقط پس از پایان موفق و بررسی، در مجموعه منتشر شده قرار گیرد. مصرف کننده نباید صرف مشاهده یک نام فایل، آماده بودن آن را نتیجه بگیرد. قرارداد انتشار اتمیک یا manifest خروجی در اینجا ارزش عملی دارد.
encoding با compression تفاوت دارد
encoding روش نمایش مقادیر را تغییر می دهد و compression تلاش می کند داده حاصل را کوچک تر کند. برای مثال مقادیر تکراری می توانند از نمایش فرهنگ واژه ای سود ببرند، در حالی که یک دنباله با الگوی مناسب ممکن است با روش دیگری کارآمدتر بیان شود. انتخاب و پشتیبانی دقیق به نویسنده، نوع داده و نسخه قالب بستگی دارد. این دو مرحله را نباید یک گزینه واحد دانست؛ codec فشرده سازی فقط بخشی از تصمیم است.
در یک ستون نام سرویس با چند مقدار تکراری، رفتار با ستون شناسه تصادفی و تقریباً یکتا فرق دارد. اگر آزمایش فقط روی داده بسیار تکراری انجام شود، نسبت فشرده سازی خوش بینانه خواهد بود. نمونه واقعی باید توزیع مقادیر و طول رشته ها را حفظ کند. همچنین حجم کمتر همیشه به معنی زمان کمتر نیست؛ هزینه CPU رمزگشایی و فشرده گشایی نیز مطرح است. هدف مناسب ممکن است کمترین هزینه کل یا زمان پاسخ مطلوب باشد، نه کوچک ترین فایل ممکن.
آمار ستون و حذف خواندن غیرضروری
متادیتای آماری، در صورت وجود و پشتیبانی، می تواند به خواننده کمک کند بخش هایی را که با شرط query سازگار نیستند کنار بگذارد. اگر یک گروه فقط رخدادهای یک بازه زمانی مشخص را داشته باشد، پرسش درباره بازه دیگر شاید نیازی به خواندن آن نداشته باشد. اما اگر زمان ها به صورت پراکنده در همه گروه ها پخش شده باشند، محدوده کمینه و بیشینه هر گروه گسترده می شود و سود حذف بخش ها کاهش می یابد. ترتیب داده در زمان نوشتن در اینجا مهم است.
برای سنجش، یک داده ثابت را یک بار مرتب بر اساس زمان و بار دیگر با ترتیب تصادفی ذخیره کنید. سپس query یک بازه کوتاه را اجرا و بایت خوانده شده را مقایسه کنید. زمان اجرا به تنهایی ممکن است به دلیل cache گمراه کننده باشد. تعداد گروه های کنار گذاشته شده و حجم خواندن شاهد مستقیم تری برای pruning هستند. نتیجه را فقط به همان شرط و همان موتور تعمیم دهید. یک ترتیب مناسب برای زمان ممکن است برای جست وجو بر اساس شناسه مشتری بهترین نباشد.
projection و predicate pushdown
انتخاب فقط ستون های لازم و نزدیک کردن فیلتر به مرحله خواندن، دو امکان مهم در موتورهای تحلیلی اند. اما شکل query می تواند بر استفاده از آن ها اثر بگذارد. تبدیل پیچیده روی ستون یا استفاده از تابعی که موتور نمی تواند به مرحله خواندن منتقل کند، ممکن است سود مورد انتظار را کم کند. بهتر است برنامه اجرا را ببینید و از روی ظاهر SQL نتیجه نگیرید که همه بهینه سازی ها انجام شده اند. پشتیبانی میان موتورهای مختلف نیز یکسان نیست.
در یک داشبورد، استفاده از انتخاب همه ستون ها حتی وقتی فقط چند ستون نمایش داده می شود، ممکن است هزینه بی دلیل بسازد. قرارداد خروجی query را محدود نگه دارید و تغییر schema را آگاهانه مدیریت کنید. همچنین مقدارهای فیلتر را با نوع درست ارسال کنید تا تبدیل ناخواسته مانع استفاده مؤثر از ساختار نشود. این نکات فقط به Parquet اختصاص ندارند، اما در خواندن فایل راه دور می توانند تفاوت محسوسی در هزینه شبکه و زمان پاسخ ایجاد کنند.
نوع منطقی و سازگاری خواننده ها
Parquet نوع های فیزیکی و اطلاعات معنایی مرتبط با نوع منطقی را از هم متمایز می کند. برای مصرف کننده، تفاوت timestamp، decimal و رشته صرفاً جزئیات نمایش نیست. واحد زمان، منطقه زمانی و دقت عدد می توانند نتیجه تحلیل را تغییر دهند. وقتی فایل میان چند موتور جابه جا می شود، باید تفسیر این نوع ها آزمایش شود. اینکه هر دو ابزار فایل را بدون خطا باز می کنند، هنوز ثابت نمی کند هر دو مقدارها را با معنای یکسان فهمیده اند.
یک مجموعه آزمون کوچک با مقدارهای مرزی بسازید: زمان نزدیک نیمه شب، عدد اعشاری با دقت حساس، مقدار خالی، رشته غیرلاتین و ساختار تو در تو. همان فایل را در موتورهای واقعی سازمان بخوانید و خروجی را مقایسه کنید. اگر اختلاف وجود دارد، آن را در قرارداد داده حل کنید، نه با تبدیل پنهان در یک dashboard. نوع داده بخشی از رابط میان تیم هاست. حفظ معنای آن برای گزارش قابل اعتماد از صرفه جویی چند درصدی حجم مهم تر است.
فایل کوچک و پارتیشن پوشه ای
ذخیره داده در پوشه های پارتیشن بندی شده می تواند به محدود کردن مجموعه فایل های لازم کمک کند، اما ساخت پوشه و فایل برای هر مقدار با تعداد بسیار زیاد معمولاً هزینه مدیریت ایجاد می کند. اگر هر رخداد در یک فایل جدا باشد، سربار باز کردن و خواندن متادیتا می تواند غالب شود. باید اندازه فایل و بسامد انتشار را با نیاز تازگی داده متعادل کرد. داده ای که هر ثانیه باید دیده شود با گزارش روزانه قرارداد یکسانی ندارد.
همچنین پارتیشن پوشه ای و row group داخل فایل را یکی ندانید. اولی به انتخاب فایل ها کمک می کند و دومی به سازمان داخل فایل مربوط است. یک طرح مناسب می تواند از هر دو استفاده کند، ولی زیاده روی در هر لایه هزینه دارد. در نمونه رخداد، پارتیشن زمانی معقول و گروه های داخلی با ترتیب مناسب می توانند نقطه شروع باشند. سپس با query های واقعی بررسی کنید که کدام لایه واقعاً خواندن را کاهش می دهد و کدام فقط تعداد فایل ها را بالا برده است.
Parquet به تنهایی جدول تراکنشی نیست
داشتن فایل های Parquet مسئله تغییر هم زمان، snapshot جدول و انتشار مجموعه فایل ها را به طور کامل حل نمی کند. برای این نیازها ممکن است قالب جدول یا لایه مدیریتی دیگری به کار رود. این تفکیک مانع توقع اشتباه می شود: Parquet ساختار یک فایل داده را توضیح می دهد، نه تمام قرارداد یک پایگاه داده چند نویسنده را. اگر دو job هم زمان فایل ها را جایگزین می کنند، باید مشخص باشد مصرف کننده کدام مجموعه را معتبر می داند.
برای یک گردش کار ساده، manifest منتشر شده پس از تکمیل همه فایل ها می تواند قرارداد کافی ایجاد کند. برای نیاز پیچیده تر، انتخاب قالب جدول باید بررسی شود. مهم این است که حذف یا جایگزینی فایل ها خارج از یک قرارداد هماهنگ انجام نشود. همچنین نسخه های قدیمی و فایل های موقت باید سیاست نگه داری داشته باشند. صرف نگه داشتن همه فایل ها تا ابد هم راه حل پایدار نیست، چون هزینه و ابهام درباره داده معتبر را افزایش می دهد.
بررسی صحت پیش از انتشار
پس از نوشتن، فقط وجود فایل را بررسی نکنید. قابلیت باز شدن، schema، تعداد ردیف و چند قاعده تجاری را کنترل کنید. برای مثال مجموع تعداد رخدادها در پارتیشن های خروجی باید با ورودی پذیرفته شده برابر باشد، مگر اینکه حذف یا تجمیع مستند انجام شده باشد. اگر داده نامعتبر کنار گذاشته می شود، تعداد و علت آن باید گزارش شود. این کنترل ها به ابزار خاصی وابسته نیستند و ارزش آن ها در جلوگیری از انتشار خروجی ظاهراً سالم اما ناقص است.
در آزمون خرابی، نویسنده را در میانه کار متوقف کنید و ببینید مصرف کننده چه چیزی می بیند. سپس اجرای دوباره را امتحان کنید تا فایل تکراری یا شمارش اضافی ایجاد نشود. نتیجه را با داده ساختگی و مسیر جدا بسنجید. Parquet زمانی بهترین ارزش را می دهد که قالب فایل، query و قرارداد انتشار با هم طراحی شوند. شناخت لایه های داخلی کمک می کند هزینه خواندن را کم کنید، اما صحت و تکرارپذیری همچنان به طراحی کامل گردش کار وابسته اند.


