
چرا این موضوع مهم است؟
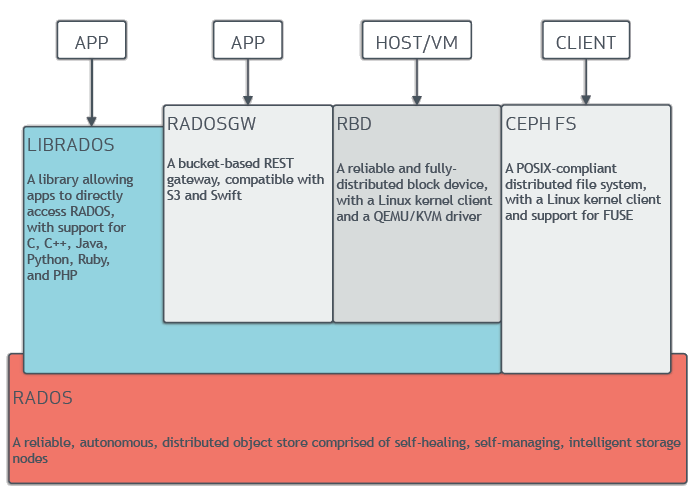
Ceph یک storage server واحد نیست؛ داده را روی مجموعهای از Object Storage Daemonها توزیع میکند. RADOS لایهٔ پایه است و RBD، CephFS و RGW روی آن ساخته میشوند. MONها نقشه و quorum را نگه میدارند و CRUSH بدون lookup مرکزی، محل placement داده را از روی topology و policy محاسبه میکند.
در یک سیستم واقعی، قبل از انتخاب ابزار باید مدل ذهنی درستی از لایهها داشته باشید. هر بار که یک مشکل را فقط با یک command یا تنظیم حفظی حل میکنیم، دانش به نسخه و محیط خاص گره میخورد. روش بهتر این است که ورودی، state، policy، مسیر داده و خروجی را مشخص کنیم. بعد ابزار را برای مشاهدهٔ یکی از این لایهها انتخاب کنیم. این رویکرد باعث میشود وقتی نسخه یا توزیع عوض شد، هنوز بدانیم دنبال چه evidenceای هستیم.
مدل معماری
در موضوع معماری ذخیرهسازی توزیعشده Ceph و مسیر داده در RADOS، componentها را روی یک مسیر ساده بکشید و مرز مسئولیت هرکدام را مشخص کنید. state پایدار، state runtime، dependency بیرونی و نقطهٔ اعمال policy را جدا کنید. وقتی diagram ساده دارید، خطا از یک «سیستم بزرگ و مبهم» به چند مرحلهٔ قابل آزمون تبدیل میشود.
روش عملی کار
یک cluster آزمایشی بسازید و برای یک pool ساده، ceph osd tree، ceph osd map و placement groupها را دنبال کنید. سپس یک OSD را از دسترس خارج کنید و ببینید health، remap و recovery چه تغییری میکنند. هدف این است که failure را به placement و redundancy وصل کنید.
برای Production، تغییر باید قابل اندازهگیری و قابل برگشت باشد. baseline قبل از تغییر شامل نسخه، config مؤثر، log سالم، metric اصلی و یک تست end-to-end است. rollout را با canary شروع کنید؛ بعد از هر مرحله هم تست مثبت و هم تست منفی داشته باشید. اگر success criterion از قبل نوشته نشده باشد، بعد از اجرا بهسادگی هر نتیجهای را میتوان «موفق» تفسیر کرد. rollback هم باید تمرین شود، نه اینکه فقط یک دستور روی کاغذ باشد.
از دید امنیت
بزرگترین اشتباه این است که replication را معادل backup بدانیم. Replica از خرابی disk محافظت میکند، اما حذف اشتباه، corruption منطقی یا credential compromise را برنمیگرداند. failure domain و network topology نیز مستقیماً روی availability اثر دارند.
از دید امنیت، کمکردن سطح دسترسی مهم است اما availability و قابلیت عیبیابی هم جزو امنیت عملیاتیاند. secretها، tokenها، capabilityها، network path و logهای حساس را جدا بررسی کنید. هر exception باید owner، دلیل و تاریخ بازبینی داشته باشد. کنترلهایی که هیچکس نمیتواند اثرشان را مشاهده یا علتشان را توضیح دهد، در زمان incident به مانع تبدیل میشوند.
آزمایشگاه پیشنهادی
یک pool با replication سهتایی بسازید، object کوچک بنویسید و mapping آن را مشاهده کنید. بعد یک failure کنترلشده ایجاد و زمان recovery و network traffic را ثبت کنید.
برای هر مرحله timestamp و خروجی را ذخیره کنید. یک failure کنترلشده ایجاد کنید تا مطمئن شوید monitoring واقعاً failure را میبیند. سپس سیستم را به baseline برگردانید و زمان recovery را ثبت کنید.
عیبیابی بر پایهٔ Evidence
Troubleshooting را با تغییر config شروع نکنید. اول محل دقیق failure را پیدا کنید: آیا ورودی وارد سیستم میشود؟ آیا state مورد انتظار ساخته شده؟ آیا policy اجازه میدهد؟ آیا خروجی از component خارج میشود؟ log، packet capture، metric و state API باید به یک timeline مشترک وصل شوند. نبودن event نیز evidence است؛ اگر request قبل از یک component دیده میشود و بعد از آن نه، دامنهٔ مسئله کوچک شده است.
Performance و ظرفیت
عملکرد را فقط با average نسنجید. p95/p99 latency، saturation، queue depth، retry و resource pressure تصویر بهتری میدهند. تغییری که در lab کوچک سریع است ممکن است زیر concurrency یا dataset واقعی bottleneck متفاوتی نشان دهد. capacity limitها را قبل از rollout بزرگ شناسایی کنید و alert را به thresholdهای قابل اقدام وصل کنید.
Production readiness
قبل از rollout نهایی، owner، change window، blast radius، success metric و rollback trigger باید مشخص باشند. اگر dependency خارجی دارید، رفتار هنگام timeout یا unavailable شدن آن را تست کنید. اگر config به چند host میرود، rollout مرحلهای و inventory دقیق لازم است. یک تغییر خوب باید observable، explainable و reversible باشد.
Runbook و انتقال دانش
در مستندسازی، فقط «چه دستورهایی اجرا شد» را ننویسید. سؤال، فرضیه، evidence مورد انتظار، نتیجه و دلیل تصمیم را ثبت کنید. اگر همکار دیگری بتواند با همان ورودی آزمایش را تکرار کند و به نتیجهٔ مشابه برسد، runbook ارزش عملیاتی دارد. اگر فقط نویسنده میداند چرا مرحلهای لازم است، دانش هنوز منتقل نشده است.
قبل از Production چه چیزی را اعتبارسنجی کنیم؟
نتیجهٔ Lab را مستقیم به Production تعمیم ندهید. یک change plan کوتاه بسازید که در آن دامنهٔ تغییر، owner، زمان اجرا، dependencyها، success metric و rollback trigger مشخص باشد. ابتدا روی canary یا درصد کوچکی از workload اجرا کنید و حداقل یک چرخهٔ واقعی restart، credential rotation یا deploy دوم را ببینید؛ بسیاری از خطاها در اولین اجرای سالم ظاهر نمیشوند. رفتار هنگام unavailable شدن dependency خارجی، پر شدن disk، timeout شبکه و ورودی نامعتبر را نیز بررسی کنید. اگر feature امنیتی است، test منفی باید نشان دهد مسیر غیرمجاز واقعاً بسته است؛ اگر feature performance است، benchmark باید با load و dataset نزدیک به واقعیت اجرا شود. در پایان، تصمیم rollout را با evidence ثبت کنید، نه با جملهٔ مبهم «بهنظر خوب است».
نگهداری بلندمدت و بازبینی دورهای
معماری بعد از deploy ثابت نمیماند. نسخهٔ سیستمعامل، dependency، policy سازمان، certificate، endpoint و حجم workload تغییر میکنند. برای همین باید بازبینی دورهای تعریف شود: نسخههای پشتیبانینشده را پیدا کنید، exceptionهای قدیمی را ببندید، alertهای بیارزش را حذف کنید و recovery را دوباره تمرین کنید. اگر configuration در Git نگهداری میشود، drift میان state واقعی و repository را اندازه بگیرید. اگر ابزار SaaS یا سرویس خارجی است، تغییر API، pricing، limit و مدل permission را دنبال کنید. مستندات باید تاریخ review داشته باشند تا تیم بداند کدام فرضها هنوز معتبرند. نگهداری خوب یعنی سیستم بعد از شش ماه هم قابل توضیح و قابل بازیابی باشد، نه اینکه فقط روز اول deploy موفق بوده باشد.
جمعبندی
هدف این مقاله دربارهٔ معماری ذخیرهسازی توزیعشده Ceph و مسیر داده در RADOS ارائهٔ یک دستور جادویی نیست؛ هدف ساختن مدل ذهنی است. وقتی معماری را بفهمید، baseline داشته باشید و تغییر را با evidence کوچک کنید، ابزارها قابل تعویض میشوند اما روش حل مسئله باقی میماند. منبع اصلی این مقاله از Ceph Documentation انتخاب شده تا جزئیات فنی قابل پیگیری باشند.
چکلیست سریع
- مسئله را در یک جمله تعریف کن.
- component و مرز اعتماد را مشخص کن.
- baseline را قبل از تغییر ذخیره کن.
- یک test مثبت و یک test منفی بساز.
- تغییر را با canary شروع کن.
- evidence را timestampدار نگه دار.
- rollback را واقعاً تمرین کن.
- نتیجه و exceptionها را در runbook ثبت کن.
از نام فایل تا محل Object
وقتی برنامه از RBD، CephFS یا درگاه Object استفاده میکند، رابطی متناسب با نیاز خود میبیند؛ اما زیر این رابطها، داده در RADOS به Objectها مربوط میشود. مسیر را با یک نمونه کوچک دنبال کنید: کلاینت باید نقشه خوشه را بشناسد، Object به placement group مرتبط میشود و قواعد CRUSH مجموعه OSDهای مناسب را تعیین میکنند. Monitor محل عبور همه بایتهای داده نیست. اگر این تفاوت روشن نباشد، ممکن است برای مشکل سرعت نوشتن، ظرفیت Monitor را زیاد کنید در حالی که محدودیت در شبکه یا دیسک OSD قرار دارد.
CRUSH برای انتخاب محل از ساختار شکست استفاده میکند. اگر سه نسخه داده روی سه دیسک یک سرور باشند، خرابی همان سرور هر سه را تهدید میکند. تعریف میزبان و رک و سایر دامنههای شکست باید با سیمکشی و برق واقعی تطابق داشته باشد. نامگذاری درخت به تنهایی استقلال ایجاد نمیکند؛ دو رک با منبع برق مشترک هنوز یک وابستگی مشترک دارند. قبل از تغییر قاعده، بررسی کنید تعداد دامنههای موجود برای برآورده کردن آن کافی است و تغییر چه حجمی از جابهجایی داده را فعال خواهد کرد.
سلامت خوشه را با سلامت یک دیسک اشتباه نگیریم
یک OSD ممکن است در حال اجرا باشد اما دیسک آن تأخیر غیرعادی داشته باشد. وضعیت up تنها بخشی از تصویر است و وضعیت in نقش آن در جایگذاری را توضیح میدهد. برای تحلیل، وضعیت PGها، درخواستهای کند، ظرفیت مصرفشده و رفتار شبکه را کنار هم ببینید. یک هشدار درباره کاهش افزونگی نیازمند تصمیم متفاوتی از هشدار کمبود فضای آزاد است. پاک کردن پیام هشدار یا تغییر آستانه آن، داده از دسترفته یا ظرفیت ناکافی را جبران نمیکند.
هنگام خروج یک دیسک، recovery و backfill بار اضافی به خوشه میآورند. برنامه کاربردی و بازیابی برای منابع مشترک رقابت میکنند. تنظیم بسیار تهاجمی بازیابی ممکن است تأخیر کاربران را بالا ببرد و تنظیم بسیار محافظهکارانه زمان آسیبپذیری را طولانی کند. انتخاب باید بر اساس اهمیت داده و تحمل بار برنامه باشد. در یک آزمایش کنترلشده، هم مدت بازگشت افزونگی و هم تأخیر درخواستهای عادی را اندازه بگیرید؛ هیچکدام به تنهایی معیار کافی نیستند.
ظرفیت خام در برابر ظرفیت قابل استفاده
مجموع اندازه دیسکها ظرفیت قابل ارائه به برنامه نیست. تکثیر یا erasure coding، فضای رزرو برای بازیابی، ناهمگونی دیسکها و محدودیتهای جایگذاری روی مقدار قابل استفاده اثر دارند. اگر همه OSDها تقریباً پر باشند، خرابی یک دیسک فقط مسئله نبود یک نسخه نیست؛ فضای کافی برای بازسازی هم وجود ندارد. پیشبینی ظرفیت باید رشد عادی داده و سناریوی خروج یک دامنه شکست را در نظر بگیرد. آستانههای پرشدن را بدون فهم پیامدها بالا نبرید.
انتخاب میان replication و erasure coding را تنها با نسبت فضای مصرفی انجام ندهید. الگوی خواندن و نوشتن، اندازه Object، تأخیر قابل قبول، قابلیتهای رابط بالادستی و هزینه بازسازی اهمیت دارند. برای نمونه یک بار کاری با نوشتنهای کوچک و پرتعداد ممکن است رفتار متفاوتی از آرشیو Objectهای بزرگ داشته باشد. ابتدا نمونهای نزدیک به همان بار را بسازید و نتیجه را برای همان pool و همان تنظیمات ثبت کنید. عدد یک benchmark عمومی را وعده عملکرد خوشه خود نکنید.
بازیابی داده و دسترسی کلاینت
وجود نسخههای متعدد جای پشتیبان مستقل را نمیگیرد. حذف منطقی یا تغییر اشتباه میتواند طبق طراحی به همه نسخهها اعمال شود. برای داده حیاتی، سناریوی حذف تصادفی را جدا از خرابی دیسک طراحی کنید و بازیابی را از دید برنامه امتحان کنید. snapshot نیز باید با قرارداد سازگاری برنامه فهمیده شود؛ تصویری از چند دیسک در زمانهای متفاوت لزوماً وضعیت سازگار یک پایگاه داده نیست.
مجوز کلاینت را به pool و عملیاتی که لازم دارد محدود کنید. کلیدی که برای یک برنامه خواندنی کافی است نباید اختیار اداره همه خوشه را داشته باشد. هنگام عیبیابی خطای دسترسی، هویت کلاینت، مقصد و قابلیتهای همان کلید را بررسی کنید؛ دادن کلید مدیر میتواند خطا را پنهان کند و دامنه آسیب را افزایش دهد. ثبت وابستگی هر برنامه به pool، رابط و کلید مشخص، در زمان چرخش اعتبارنامه و جابهجایی سرویس بسیار کمک میکند.


