
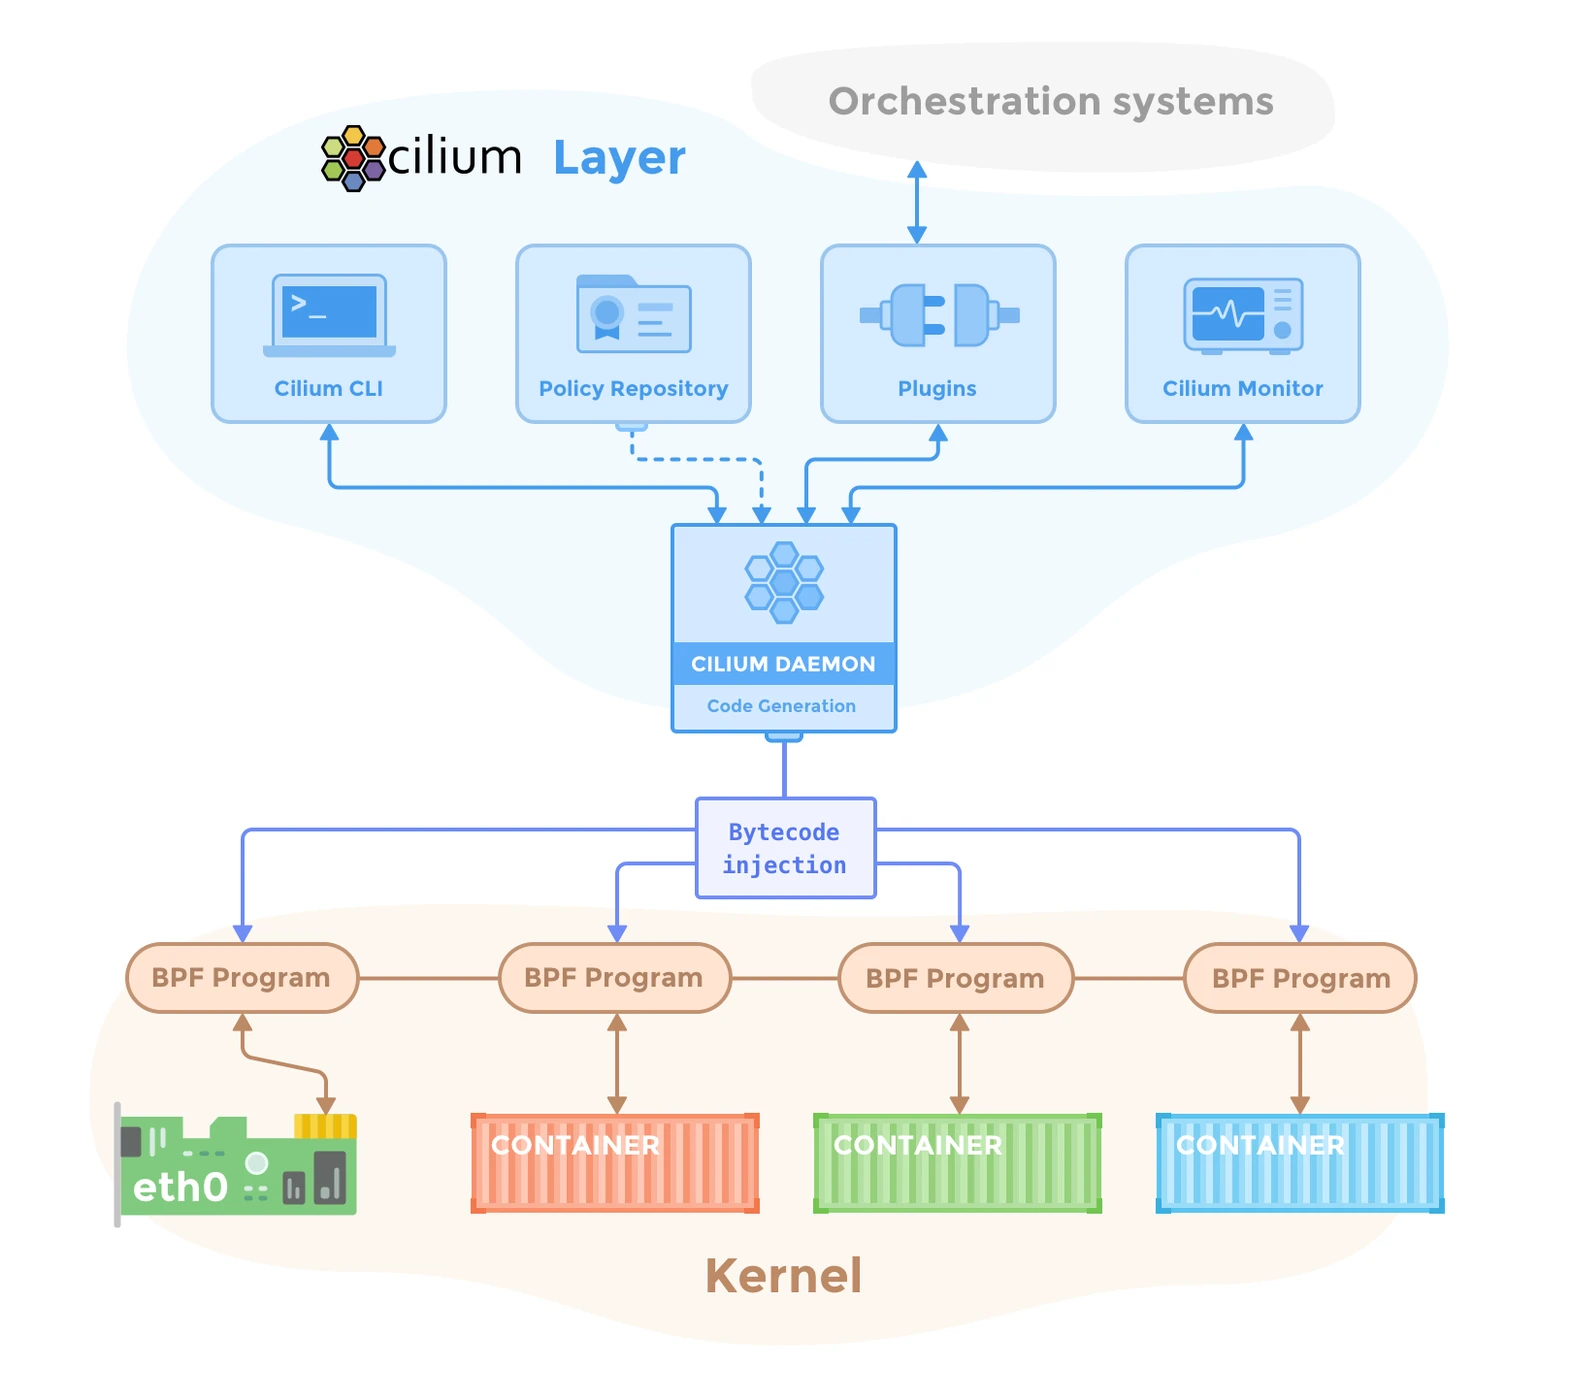
اجزای اصلی چه میکنند؟
Cilium از سازوکارهای eBPF برای بخشی از شبکه و امنیت بارهای کاری استفاده میکند. در نمودار رسمی، عاملهای روی گرهها در کنار مؤلفههای سطح خوشه قرار میگیرند. Operator مسئول بخشی از کارهای هماهنگی خوشه است؛ نقش آن با عامل حاضر در مسیر شبکه هر گره یکسان نیست.
Hubble برای مشاهده جریانهای شبکه و درک ارتباط سرویسها به این مجموعه اضافه میشود. Relay امکان گردآوری دید چند گره را فراهم میکند. این تصویر مشاهدهپذیری میتواند در تشخیص ارتباط ردشده یا مشکل رسیدن به یک سرویس کمک کند، اما خودش به معنی ایجاد خودکار سیاست مناسب نیست.
هویت با آدرس لحظهای فرق دارد
در محیط کانتینری، IPها تغییر میکنند. اتصال سیاست به هویت و برچسبهای بار کاری، مسئله متفاوتی از نوشتن فهرست ثابت آدرسهاست. بااینحال درستبودن برچسبها و مرزهای دسترسی نیز باید بررسی شود؛ نام زیبا برای یک Pod، خودبهخود سیاست امن ایجاد نمیکند.
سناریوی عیبیابی پیشنهادی
فرض کنید وب به API وصل نمیشود. ابتدا روشن کنید شکست در حل نام است، برقراری اتصال است یا پاسخ برنامه. سپس جریان مربوط به همان زمان و همان دو بار کاری را بررسی کنید. یک رخداد قدیمی یا ارتباط به replica دیگر ممکن است شما را به نتیجه اشتباه برساند.
در آزمایش کنترلشده، یک ارتباط را عمداً ممنوع کنید و ببینید چه نشانهای ثبت میشود. سپس اجازه محدود و مشخص بدهید و همان آزمون را تکرار کنید. این روش به تیم کمک میکند تفاوت «هیچ ترافیکی تولید نشده»، «ترافیک به مقصد نرسیده» و «سیاست آن را رد کرده» را بشناسد.
محدودیت دید
از مشاهده شبکه انتظار خواندن خودکار محتوای همه ارتباطهای رمزشده نداشته باشید. عمق دید به پروتکل، تنظیمات و مؤلفههای فعال بستگی دارد. پیشنهاد تحریریه این است که لاگ برنامه و شناسه درخواست را کنار شواهد شبکه نگه دارید؛ یک ابزار شبکه بهتنهایی همه علتهای خطای کاربردی را نشان نمیدهد.
مسیر بسته را پیش از نوشتن سیاست بشناسید
برای فهم یک ارتباط، مبدأ را فقط نام سرویس نبینید. Pod مبدأ روی یک گره قرار دارد، مقصد ممکن است روی گره دیگر باشد و یک Service نیز میتواند میان نام منطقی و endpoint واقعی واسطه شود. درخواست DNS پیش از اتصال برنامه، مسیری جدا دارد. در یک تمرین ساده، نام سرویس را از داخل همان Pod حل کنید، سپس اتصال به پورت مورد انتظار را بسنجید و در پایان درخواست کاربردی بفرستید. این سه مرحله کمک میکنند خطای حل نام، خطای شبکه و خطای برنامه به اشتباه یک مسئله تلقی نشوند.
مسیر میان گرهها به حالت شبکه انتخابی و زیرساخت وابسته است. اگر بسته روی یک گره مجاز است اما به گره دیگر نمیرسد، تنها سیاست برنامه را تغییر ندهید. مسیریابی میزبان، فایروال زیرساخت، اندازه بسته قابل عبور و سلامت رابطها را نیز بررسی کنید. در آزمایش، دو Pod روی یک گره و دو Pod روی گرههای متفاوت انتخاب کنید. تفاوت نتیجه این دو جفت سرنخ مهمی درباره مرز خرابی میدهد. هویت Pod و زمان ایجاد آن را ثبت کنید تا جابهجایی خودکار برنامه، نتیجه را مبهم نکند.
سیاست را به قرارداد برنامه تبدیل کنید
پیش از نوشتن YAML، جملهای روشن بنویسید: «وب در این namespace باید فقط به پورت مشخص API وصل شود و API به پایگاه داده خودش دسترسی داشته باشد.» سپس برچسبهای لازم برای تشخیص این نقشها را مشخص کنید. برچسبی که همه برنامهها آزادانه میتوانند به خود بدهند، به خودی خود مرز اعتماد قوی ایجاد نمیکند. مسئول مدیریت برچسبها و اختیار تغییر workload باید با طراحی سیاست هماهنگ باشد. امنیت شبکه به سیاست دسترسی Kubernetes نیز وابسته میماند.
محدودیت ingress و egress را جدا بررسی کنید. مجاز بودن خروج از مبدأ لزوماً اجازه ورود در مقصد را ایجاد نمیکند و برعکس. وقتی چند سیاست به یک endpoint مربوط میشوند، نتیجه را از مجموع قواعد مؤثر همان پیادهسازی بخوانید. ترتیب ظاهری فایلها را مانند یک فایروال خطی فرض نکنید. برای هر تغییر، یک جدول کوچک از ارتباطهای مجاز و غیرمجاز بسازید و همان جفتها را پیش و پس از تغییر آزمایش کنید. چنین جدولی از توضیح مبهم «شبکه باید امنتر شود» قابل سنجشتر است.
ارتباطهای زیرساختی برنامه را فراموش نکنید. یک برنامه ممکن است به DNS، سرویس هویت یا مقصد دریافت تنظیمات نیاز داشته باشد. مسدودشدن این مسیرها گاهی به شکل خطای غیرمستقیم ظاهر میشود؛ مثلاً برنامه بالا میآید ولی نخستین درخواست کاربر شکست میخورد. اجازه گسترده به همه مقصدها برای رفع این خطا، هدف محدودسازی را از بین میبرد. به جای آن، جریان لازم را با زمان و مقصد مشخص مشاهده کنید و وابستگی را به قرارداد برنامه اضافه کنید.
خواندن Hubble با فرضیه مشخص
Hubble زمانی مفید است که پرسشی مشخص داشته باشید: آیا اتصال از مبدأ مورد نظر تولید شده؟ به کدام مقصد رسیده؟ آیا تصمیم policy آن را رد کرده؟ آیا پاسخ برگشته است؟ فیلتر زمان، namespace و workload دامنه جستوجو را کوچک میکند. اگر فقط همه جریانها را نگاه کنید، ترافیک background و health check ممکن است درخواست واقعی شما را پنهان کند. برای یک آزمایش، شناسه درخواست یا بازه زمانی کوتاه تعیین کنید و آن را با log برنامه تطبیق دهید.
نبودن یک جریان در خروجی چند تفسیر دارد. ممکن است برنامه هنوز درخواست نفرستاده باشد، نقطه مشاهده مناسب انتخاب نشده باشد، داده قدیمی از دسترس خارج شده باشد یا خود مسیر جمعآوری مشکل داشته باشد. بنابراین «در Hubble چیزی نیست» به تنهایی اثبات خرابی شبکه نیست. ابتدا یک ارتباط شناختهشده و سالم تولید کنید تا سلامت مشاهدهپذیری همان گره روشن شود. سپس جریان مسئلهدار را مقایسه کنید. این کنترل ساده از دنبال کردن مشکل ساختگی ناشی از خرابی ابزار مشاهده جلوگیری میکند.
دید چندگرهی به Relay و اتصال آن به اجزای مربوط وابسته است. اگر تنها بخشی از خوشه دیده میشود، قبل از نتیجهگیری درباره رفتار برنامه، پوشش دید را بررسی کنید. فهرست گرههای مورد انتظار را با گرههای واقعاً قابل مشاهده مقایسه کنید. رخدادی روی گره غایب ممکن است کاملاً از جستوجوی شما بیرون بماند. وضعیت رابط کاربری نیز همه چیز را توضیح نمیدهد؛ باید معلوم باشد داده از کدام حسگر و چه بازهای آمده است.
خطای MTU و نشانههای گمراهکننده
گاهی اتصال TCP برقرار میشود ولی انتقال پاسخ بزرگ متوقف میماند. این الگو با رد شدن همه اتصالها فرق دارد و میتواند به مسیر شبکه و اندازه بسته مربوط باشد. یک پاسخ کوچک و یک پاسخ بزرگ آزمایشی را مقایسه کنید و مسیر میان گرهها را در نظر بگیرید. تغییر تصادفی timeout برنامه، مشکل اندازه بسته را برطرف نمیکند و فقط زمان انتظار را طولانیتر میکند. نتیجه را با capture محدود و مجاز و شمارندههای شبکه تأیید کنید تا فرضیه به شواهد متصل بماند.
اگر تنها یک گره مشکل دارد، وضعیت agent همان گره، endpointها و تغییرات اخیر آن را بررسی کنید. حذف و ایجاد دوباره همه Podها ممکن است موقتاً بار را به گره سالم ببرد و علت اصلی را پنهان کند. ابتدا نمونه مشکلدار را قابل تکرار نگه دارید و سپس یک تغییر کوچک انجام دهید. در سامانهای که scheduler مرتب محل برنامه را عوض میکند، ثبت نام گره بخش ضروری گزارش عیبیابی است.
سیاست لایه کاربرد و رمزگذاری
قواعد مبتنی بر پروتکل کاربردی به قابلیت و تنظیمات مسیر مربوط وابستهاند. نام یک قابلیت در مستندات به معنی فعال بودن آن برای همه ترافیک خوشه نیست. بهویژه وقتی داده رمزگذاری شده است، مشاهده محتوا به محل خاتمه رمزگذاری و نحوه یکپارچگی وابسته میشود. قبل از وعده محدودکردن مسیرهای HTTP، بررسی کنید ابزار در همان نقطه واقعاً درخواست HTTP را میبیند. در غیر این صورت سیاست باید در لایهای اعمال شود که اطلاعات لازم در دسترس است.
هویت سرویس در شبکه با هویت کاربر نهایی یکسان نیست. یک Pod مجاز ممکن است درخواست کاربران مختلف را پردازش کند. مجاز بودن ارتباط آن با API، جای کنترل مجوز در خود API را نمیگیرد. آزمایش کاربردی باید نشان دهد کاربر غیرمجاز حتی با وجود مسیر شبکه سالم به داده دسترسی ندارد. این جداسازی باعث میشود سیاست شبکه یک لایه کاهش دامنه آسیب باشد و مسئولیتهای برنامه به اشتباه به آن واگذار نشوند.
پذیرش تغییر و نگهداری روزمره
برای rollout، نخست یک namespace آزمایشی با چند نقش مشخص بسازید. نمونه policy را روی همان نقشها اعمال کنید و تمام ارتباطهای مورد انتظار را دوباره بسنجید. سپس رفتار restart و جابهجایی Pod را آزمایش کنید؛ سیاست وابسته به هویت باید پس از تغییر IP نیز نتیجه مورد انتظار داشته باشد. اگر آزمون فقط با آدرس ثابت قبلی موفق است، هنوز قرارداد پویای محیط کانتینری اثبات نشده است.
در گزارش نهایی نسخه اجزای نصبشده، حالت شبکه، سیاستهای مرتبط و شاهد جریان ردشده یا مجاز را کنار هم نگه دارید. شمار هشدار یا تعداد policy به تنهایی معیار بلوغ نیست. معیار بهتر این است که تیم بتواند یک ارتباط ضروری را توضیح دهد، ارتباط نامجاز را با شاهد رد کند و خرابی زیرساخت را از خطای policy جدا تشخیص دهد. این توانایی هنگام انتشار برنامه جدید و تغییر وابستگیها بسیار ارزشمندتر از یک مجموعه YAML بدون مالک خواهد بود.
بازبینی دسترسی به دادههای مشاهده
جریانهای شبکه میتوانند نام سرویسها، نشانیها و الگوی ارتباط داخلی سازمان را آشکار کنند. دسترسی مشاهده را برای تیمهایی تعریف کنید که به این اطلاعات نیاز دارند و خروجی تشخیصی را مانند داده عمومی منتشر نکنید. هنگام اشتراک یک نمونه برای پشتیبانی، اطلاعات غیرضروری را حذف کنید ولی رابطه مبدأ، مقصد و زمان را حفظ کنید تا نمونه هنوز قابل تحلیل باشد. حذف همه زمینهها نیز گزارش را بیفایده میکند؛ هدف کاهش داده اضافی است.
همچنین نگهداری داده باید با نیاز بررسی رخداد تناسب داشته باشد. اگر مسئله معمولاً پس از پایان یک شیفت گزارش میشود ولی جریانها پیش از آن از دسترس خارج میشوند، تیم شاهد لازم را نخواهد داشت. این نیاز را با هزینه و حساسیت داده موازنه کنید و محدوده زمانی قابل جستوجو را به کاربران ابزار توضیح دهید. هنگام پاسخ به یک حادثه قدیمی، صریح بنویسید کدام بازه و کدام گرهها پوشش داشتهاند. چنین گزارشی از نتیجهگیری قطعی بر اساس دید ناقص جلوگیری میکند و اعتماد به تحلیل شبکه را افزایش میدهد.


