
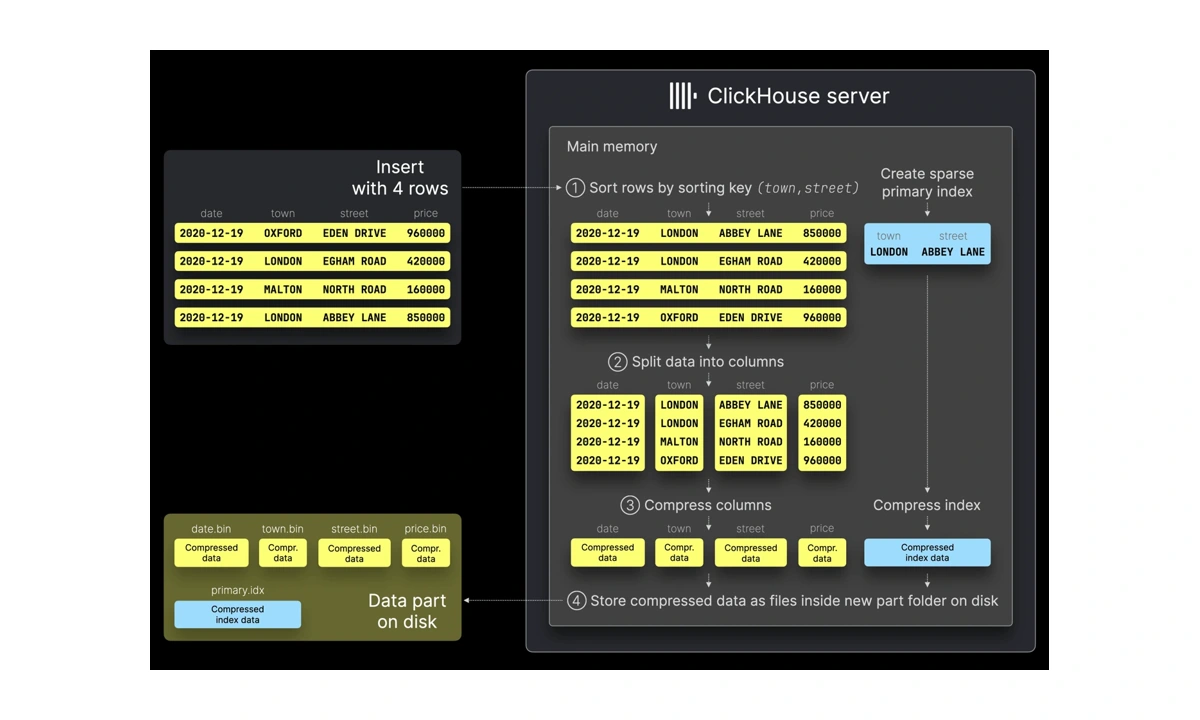
از ردیف ورودی تا بخش ذخیره شده
در ClickHouse خانواده موتورهای MergeTree داده را در قالب بخش هایی مرتب و فشرده نگه می دارد که معمولاً data part نامیده می شوند. این مدل برای تحلیل حجم زیاد داده طراحی شده است و رفتار آن با جدولی که هر ردیف را فوراً در محل نهایی بازنویسی می کند تفاوت دارد. برای اداره درست سیستم، باید بفهمیم هر درج چه اثری بر تعداد بخش ها دارد، ترتیب داده چگونه به حذف خواندن غیرضروری کمک می کند و ادغام پس زمینه چه هزینه ای می سازد. صرف دانستن دستور ایجاد جدول برای تصمیم عملیاتی کافی نیست.
یک سامانه جمع آوری رخداد را در نظر بگیرید که از هزاران دستگاه پیام می گیرد. هر پیام شامل زمان، شناسه مشتری، نوع رخداد و چند مقدار اندازه گیری است. پرسش اصلی معمولاً درباره یک مشتری در یک بازه زمانی است، نه درباره همه ستون های یک پیام تصادفی. طراحی جدول باید همین الگوی دسترسی را منعکس کند. اگر ترتیب ذخیره با پرسش رایج هماهنگ نباشد، موتور ممکن است برای پاسخ کوچک مقدار زیادی داده بخواند. سخت افزار سریع تر این هزینه را پنهان می کند، اما علت آن را از بین نمی برد.
بخش های مستقل و ادغام پس زمینه
هر دسته درج می تواند یک یا چند بخش داده ایجاد کند. این بخش ها بعداً در پس زمینه ادغام می شوند تا سازمان ذخیره کارآمدتر بماند. بنابراین الگوی ارسال داده فقط بر تأخیر ورود اثر ندارد؛ بر تعداد فایل ها و مقدار کار نگه داری هم اثر می گذارد. فرستادن پی در پی دسته های بسیار کوچک می تواند تعداد بخش ها را بالا ببرد. در چنین وضعیتی CPU و دیسک ممکن است برای مدیریت و ادغام داده بیشتر از اجرای پرس وجوی مورد انتظار مصرف شوند.
پیش از تغییر تنظیمات محدودکننده، رفتار تولید کننده را بررسی کنید. آیا هر رخداد جدا ارسال می شود؟ آیا هر worker بافر مستقل و بسیار کوچکی دارد؟ آیا افزایش تعداد worker ناخواسته تعداد درج ها را چند برابر کرده است؟ گاهی با دسته بندی مناسب می توان مشکل را در مبدأ حل کرد. البته دسته بزرگ تر تأخیر ورود و حافظه بافر را افزایش می دهد. اندازه دسته باید حاصل توازن میان تازگی داده، ظرفیت حافظه و هزینه ادغام باشد، نه عددی که بدون آزمایش از یک مقاله کپی شده است.
ORDER BY یک قرارداد عملکردی است
عبارت ORDER BY ترتیب داده داخل بخش ها را تعیین می کند. اگر گزارش ها معمولاً ابتدا مشتری و سپس زمان را محدود می کنند، قرار دادن این ابعاد در ترتیب مناسب ممکن است خواندن را کاهش دهد. اما ترتیب به معنای تضمین یکتایی ردیف ها نیست. توسعه دهنده ای که از پایگاه داده تراکنشی می آید نباید از نام primary key نتیجه بگیرد هر درج تکراری رد می شود. ساختار شاخص کم تراکم در این خانواده برای کاهش محدوده خواندن طراحی شده و قرارداد یکتایی باید جدا بررسی شود.
برای انتخاب ترتیب، چند query نماینده جمع کنید. فقط پرکاربردترین query را نبینید؛ query نادر اما بسیار سنگین نیز ممکن است هزینه عمده ایجاد کند. تعداد ردیف و بایت خوانده شده را برای چند طرح آزمایشی مقایسه کنید. اگر یکی از مشتری ها بیشتر داده را تولید می کند، توزیع نامتوازن را در نمونه حفظ کنید. یک آزمایش با مشتری های هم اندازه می تواند نتیجه گمراه کننده بدهد. طرح مناسب باید نسبت به الگوی واقعی داده و پرسش ها قابل دفاع باشد.
پارتیشن بندی چه مسئله ای را حل می کند؟
پارتیشن بندی ابزاری برای تقسیم داده به مجموعه های مدیریتی و کمک به حذف بخش های نامرتبط از خواندن است. معمولاً ابعاد زمانی برای داده رخداد معنی دارند، چون نگه داری و حذف داده نیز بر اساس زمان انجام می شود. با این حال ساخت پارتیشن برای هر مقدار با cardinality بالا می تواند تعداد بخش های کوچک را افزایش دهد. استفاده از شناسه هر دستگاه به عنوان پارتیشن، فقط به این دلیل که query ها دستگاه را فیلتر می کنند، لزوماً انتخاب خوبی نیست.
ترتیب داده و پارتیشن بندی دو اهرم مستقل اند. اولی چیدمان داخل بخش را شکل می دهد و دومی مرز مجموعه هایی را می سازد که داده در آن ها سازمان می یابد. در نمونه رخداد، ممکن است پارتیشن ماهانه و ترتیب بر اساس مشتری و زمان منطقی باشد، ولی این صرفاً نقطه شروع آزمایش است. اگر چرخه نگه داری روزانه یا حجم هر ماه بسیار متفاوت باشد، انتخاب دیگری بهتر است. مهم این است که دلیل هر کلید را به یک نیاز مشخص وصل کنید.
هزینه ادغام را در ظرفیت حساب کنیم
ظرفیت ذخیره فقط مجموع بایت های نهایی داده نیست. عملیات پس زمینه برای ساخت بخش های جدید و کنار گذاشتن بخش های قدیمی به فضای کاری و پهنای باند احتیاج دارد. اگر دیسک همیشه نزدیک ظرفیت نهایی باشد، سیستم فضای مانور کمی خواهد داشت. همین طور اگر همه توان دیسک به درج و query اختصاص داده شود، ادغام ممکن است عقب بماند. برنامه ظرفیت باید بار ورودی، خواندن تحلیلی و کار نگه داری را هم زمان در نظر بگیرد.
نمودار تعداد بخش ها در طول زمان به اندازه حجم کل داده آموزنده است. افزایش مداوم بخش های کوچک با وجود حجم ورودی ثابت می تواند نشانه تغییر اندازه batch یا عقب افتادن merge باشد. برای تشخیص، زمان شروع تغییر را با استقرار نسخه تولید کننده مقایسه کنید. اگر هم زمان تعداد worker ها دو برابر شده است، شاید علت در سمت مصرف کننده پایگاه داده نباشد. بررسی زنجیره کامل ورود داده اغلب از افزایش فوری thread های پس زمینه مؤثرتر است.
داده تکراری و انتخاب موتور مشتق
ورود دوباره پیام در سامانه های توزیع شده طبیعی است. قطع ارتباط پس از ارسال ممکن است تولید کننده را درباره نتیجه درج نامطمئن کند. اینکه تکرار چگونه کنترل شود به موتور، روش درج و قرارداد شناسه پیام بستگی دارد. نباید فرض کرد همه جدول های MergeTree خودکار هر تکرار تجاری را حذف می کنند. پیش از انتخاب یک موتور مشتق، مشخص کنید تکرار به چه معناست: برابری همه ستون ها، شناسه رویداد یکسان یا نسخه جدید یک موجودیت؟
در تحلیل رخداد، یک راه روشن این است که شناسه رخداد در مبدأ ساخته شود و سیاست برخورد با تکرار مستند باشد. برای موجودیت های قابل تغییر، ممکن است شماره نسخه یا زمان معتبر تغییر لازم شود. اگر به رفتار ادغام تکیه می کنید، نتیجه پیش از ادغام و پس از ادغام را جدا آزمایش کنید. query ای که برای صحت به یک عملیات تکمیلی وابسته است باید این وابستگی را آشکار داشته باشد. حذف تکرار نباید به امید اجرای یک merge در زمان نامعلوم واگذار شود.
حذف و تغییر داده را از ابتدا طراحی کنیم
یک سیستم تحلیلی هم ممکن است نیاز به اصلاح داده اشتباه، حذف اطلاعات منقضی یا اعمال سیاست نگه داری داشته باشد. این عملیات در مدل بخش های ذخیره شده هزینه متفاوتی با تغییر یک ردیف در سامانه تراکنشی دارد. پیش از تولید، تعداد و بسامد اصلاح ها را برآورد کنید. اگر بیشتر داده هر چند دقیقه بازنویسی می شود، باید تناسب مدل با مسئله را بررسی کرد. مناسب بودن برای درج انبوه به معنی مناسب بودن همه الگوهای به روز رسانی نیست.
برای سیاست حذف زمانی، تعریف دقیق زمان مهم است. آیا زمان رخداد معیار است یا زمان دریافت؟ یک دستگاه آفلاین ممکن است داده قدیمی را امروز بفرستد. اگر حذف بر اساس زمان رخداد باشد، داده تازه دریافت شده شاید خیلی زود مشمول حذف شود. اگر بر اساس زمان دریافت باشد، بازه واقعی نگه داری رخداد تغییر می کند. این تصمیم تجاری باید پیش از نوشتن عبارت فنی گرفته شود. پایگاه داده نمی تواند ابهام در قرارداد نگه داری را به جای تیم حل کند.
پایش با پرسش عملیاتی
داشبورد خوب باید به پرسش پاسخ دهد: آیا ورود داده عقب افتاده است؟ آیا تعداد بخش ها رشد غیرعادی دارد؟ آیا query ها داده بیشتری از قبل می خوانند؟ آیا خطا ناشی از کمبود فضاست یا فشار هم زمانی؟ برای هر پرسش، یک یا چند متریک و یک اقدام مشخص تعیین کنید. نمایش ده ها عدد بدون ارتباط با تصمیم، در رخداد واقعی کمک محدودی می کند. آستانه ها نیز باید با روند عادی سرویس مقایسه شوند، نه صرفاً عدد پیش فرض.
یک نمونه مفید، مقایسه حجم خوانده شده با حجم نتیجه است. اگر گزارش چند صد ردیفی ناگهان چند برابر داده می خواند، ممکن است query تغییر کرده یا pruning کمتر مؤثر شده باشد. در مقابل، اگر خواندن ثابت است ولی زمان پاسخ بیشتر شده، رقابت منابع یا وضعیت دیسک مطرح می شود. این تفکیک مانع تغییر هم زمان چند تنظیم می شود. هر اصلاح را با یک فرضیه و یک معیار پیش و پس از تغییر اجرا کنید تا علت بهبود یا افت مشخص بماند.
آزمایش ورودی و خرابی
در محیط آزمایشی، نرخ درج را تدریجی افزایش دهید و هم زمان query های نماینده اجرا کنید. فقط نقطه بیشینه throughput را ثبت نکنید؛ پایداری تعداد بخش ها و تأخیر انتهایی نیز مهم است. اگر پس از پایان تست، سیستم مدت زیادی درگیر ادغام باقی می ماند، بار آزمایش بخشی از هزینه را به آینده منتقل کرده است. برای مقایسه منصفانه، دوره آرام شدن سیستم را هم اندازه بگیرید و حجم کاری باقی مانده را گزارش کنید.
سناریوی قطع تولید کننده را نیز امتحان کنید. پس از شروع دوباره، آیا backlog با سرعتی وارد می شود که سیستم را از حالت پایدار خارج کند؟ کنترل نرخ بازیابی می تواند به اندازه نرخ عادی مهم باشد. سپس یک batch را عمداً دوباره بفرستید و نتیجه شمارش را بررسی کنید. این آزمایش ها به شما نشان می دهند قرارداد واقعی ورود داده چیست. اطمینان از صحت گزارش بر اساس پیام های تحویل شده، بسیار مهم تر از ثبت یک عدد جذاب برای درج در ثانیه است.
تصمیم نهایی برای یک جدول
پیش از انتشار جدول، یک صفحه قرارداد بنویسید: نوع داده، ترتیب، پارتیشن، شناسه تکرار، سیاست اصلاح و نگه داری، query های اصلی و معیار ظرفیت. این سند کوتاه باعث می شود تغییرهای بعدی با آگاهی انجام شوند. اگر تیم دیگری تولید کننده را تغییر می دهد، بداند کوچک کردن batch یا افزودن یک بعد جدید چه پیامدی دارد. مدل ذخیره تنها متعلق به مدیر پایگاه داده نیست؛ تولید کننده و مصرف کننده نیز در کارایی آن سهم دارند.
MergeTree زمانی خوب کار می کند که ورود داده، چیدمان و پرسش تحلیلی با هم طراحی شوند. هیچ تنظیم واحدی جای این هماهنگی را نمی گیرد. از یک طرح ساده و قابل اندازه گیری شروع کنید، رفتار بخش ها را ببینید و فقط بر اساس شواهد تغییر دهید. هدف این نیست که همه مفاهیم پیشرفته را از روز اول فعال کنید؛ هدف ساخت جدولی است که نتیجه درست، هزینه قابل پیش بینی و مسیر نگه داری روشن داشته باشد.


