
چه چیزی را بازیابی میکنیم؟
etcd یک مخزن کلید و مقدار توزیعشده است. راهنمای بازیابی نسخه 3.6، تهیه snapshot و بازگرداندن آن با ابزار مناسب را توضیح میدهد. هنگام restore، هویت عضو و خوشه بازسازی میشود تا داده بازیابیشده ناخواسته به خوشه قدیمی متصل نشود. مسیر بازیابی باید بر اساس مستندات نسخه نصبشده انتخاب شود.
در Kubernetes، بازگرداندن وضعیت etcd به معنی بازگرداندن تمام داده برنامهها نیست. دادهای که برنامه در یک دیسک، پایگاه داده خارجی یا فضای شیء نگه میدارد، لایه جداگانهای از برنامه بازیابی است.
چرا Revision مهم است؟
مصرفکنندگان etcd ممکن است تغییرها را با watch دنبال کنند. بازیابی snapshot قدیمی میتواند شماره بازبینی داده را عقب ببرد، درحالیکه بعضی مصرفکنندگان وضعیت جدیدتری را به خاطر دارند. راهنمای رسمی برای سناریوهایی مانند Kubernetes، افزایش revision و علامتگذاری فشردهسازی را در طراحی restore مطرح میکند. این گزینهها باید بهعنوان بخشی از روند بازیابی آزموده شوند، نه دستورهایی که بدون شناخت نسخه روی محیط عملیاتی اجرا میشوند.
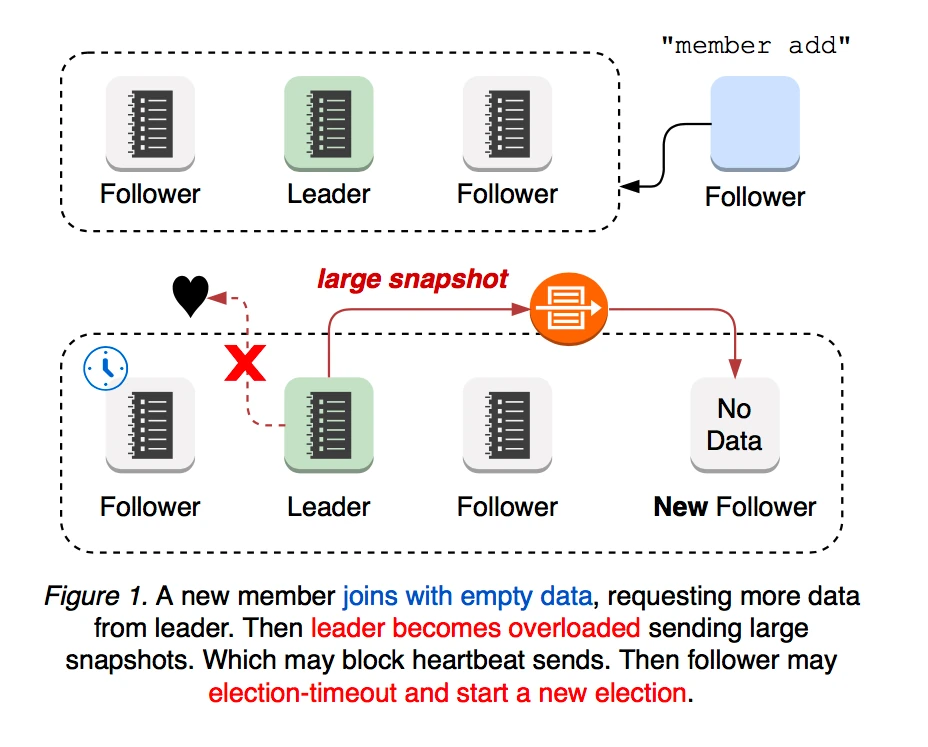
نمودار همراه از مستند رسمی طراحی عضو learner آمده است. هدف استفاده از آن، نشاندادن رابطه اعضا و اهمیت تصمیم درباره عضویت است؛ خود نمودار دستور بازیابی snapshot نیست.
تمرین پیشنهادی تحریریه
در یک خوشه کاملاً آزمایشی، چند داده با نام و مقدار قابل تشخیص ایجاد کنید و زمان snapshot را ثبت کنید. بعد از snapshot، یک تغییر دیگر انجام دهید. پیش از restore بنویسید کدام مقدار باید برگردد و کدام تغییر، طبق هدف بازیابی، قرار است از دست برود.
آزمون را فقط با موفقیت فرمان restore تمام نکنید. یک کلاینت مستقل باید بتواند داده مورد انتظار را بخواند، تغییر تازه ایجاد کند و رویداد آن را دریافت کند. برای محیط کنترلی Kubernetes، سلامت کنترلگرها و رفتار منابع منتخب نیز بخشی از معیار پذیرش است.
شواهدی که باید نگه دارید
شناسه snapshot، نسخه ابزار، زمان تهیه، نتیجه بررسی سلامت و مقصد آزمایش را ثبت کنید. مسیر کلیدها و گواهیهای لازم باید در برنامه بازیابی معلوم باشد، اما خود اسرار نباید وارد گزارش عمومی شوند. پیشنهاد ما اجرای تمرین با دسترسی محدود و دستورالعملی است که فرد دیگری نیز بتواند آن را دنبال کند.
مرز تصمیم
از دست رفتن یک عضو با از دست رفتن اکثریت خوشه یک مسئله واحد نیست. پیش از تصمیم، وضعیت واقعی اعضا و مسیرهای شبکه را مشخص کنید. restore عجولانه در حالی که خوشه اصلی هنوز فعال است میتواند دو وضعیت ناسازگار بسازد. این مقاله جای دستورالعمل بازیابی اختصاصی زیرساخت شما را نمیگیرد.
اول نوع خرابی را تشخیص دهید
در یک خوشه etcd، از دست دادن یک عضو با از دست دادن اکثریت اعضا یکسان نیست. اگر اکثریت سالم و در دسترس باشد، مسیر معمول جایگزینی عضو خراب با بازیابی کل خوشه فرق دارد. آغاز restore عمومی برای خرابی محدود ممکن است وضعیت سالم را هم کنار بگذارد. ابتدا تعداد اعضا، دسترسی شبکه، سلامت دیسک و وضعیت quorum را ثبت کنید. مشخص کنید آیا داده قابل خواندن است و آیا خوشه هنوز میتواند نوشتن را بپذیرد. این تشخیص تعیین میکند با تعمیر عضو روبهرو هستید یا بازیابی پس از فاجعه.
Snapshot نمایی از داده در یک زمان مشخص است. اگر پس از آن تغییراتی ثبت شده باشند، بازگشت به snapshot آن تغییرات را بازنمیگرداند. بنابراین زمان فایل و revision آن باید در گزارش پشتیبان وجود داشته باشد. داشتن یک فایل بزرگ روی دیسک ثابت نمیکند آخرین وضعیت مطلوب در آن است. برای یک سامانه وابسته مانند Kubernetes، فاصله زمانی پشتیبان میتواند شامل ایجاد یا حذف منابع مهم باشد و باید در تصمیم پذیرش اتلاف داده لحاظ شود.
تفاوت تهیه snapshot و کپی فایل داده
مسیر تهیه پشتیبان باید با مستندات نسخه نصبشده هماهنگ باشد. snapshot گرفتهشده از endpoint سالم، سازوکاری برای بررسی یکپارچگی دارد. کپی مستقیم فایل backend از عضو نیز محدودیتهای دیگری دارد و ممکن است تغییراتی که هنوز در فایل پایگاه داده منعکس نشدهاند را در بر نگیرد. در نتیجه این دو روش را بدون بررسی معادل ندانید. نام ابزار، نسخه، endpoint، زمان و نتیجه بررسی فایل را همراه پشتیبان نگه دارید تا در حادثه معلوم باشد دقیقاً چه چیزی در اختیار دارید.
پشتیبان را خارج از دیسک و دامنه خرابی همان خوشه نگه دارید. اگر همه اعضا و نسخه پشتیبان روی یک میزبان یا فضای مشترک آسیبپذیر باشند، خرابی آن محل همه نسخهها را از بین میبرد. دسترسی به فایل نیز باید محدود باشد؛ etcd ممکن است داده حساس کنترلپلین را نگه دارد. رمزنگاری در انتقال و محل نگهداری، ثبت دسترسی و دوره نگهداری بخشی از طرح پشتیبان هستند. پشتیبان قدیمی قابل خواندن همچنان میتواند اطلاعات حساسی داشته باشد، حتی اگر دیگر برای restore مناسب نباشد.
Restore یک خوشه منطقی تازه میسازد
در بازیابی، فایل snapshot به data directory تازه تبدیل میشود و هویت اعضا و خوشه باید طبق فرایند restore بازسازی شود. تصور اینکه میتوان فایل را روی هر عضو قبلی کپی کرد و همه چیز به شکل قبلی ادامه مییابد، خطرناک است. نام عضو، نشانی peer و فهرست اعضای اولیه باید با طرح جدید سازگار باشند. برای هر عضو، تنظیم مشخص تهیه کنید و قبل از شروع، تداخل با اعضای قدیمی را حذف کنید. ارتباط اتفاقی میان دو مجموعه با هویت و وضعیت ناسازگار میتواند تشخیص را پیچیده کند.
همه اعضای خوشه بازیابیشده باید از snapshot انتخابشده یکسان ساخته شوند. ترکیب فایلهای گرفتهشده در زمانهای مختلف برای اعضای مختلف، روش ساخت یک تصویر سازگار نیست. شناسه و checksum فایل ورودی را در هر گره بررسی کنید. data directory قبلی را تا زمانی که علت حادثه و نتیجه بازیابی روشن نشده بیدلیل حذف نکنید؛ میتواند برای بررسی بعدی مفید باشد. در عین حال، مسیر اجرای سرویس باید صریحاً به directory تازه اشاره کند تا داده قدیمی اشتباهی بارگذاری نشود.
چرا revision برای مصرفکننده اهمیت دارد؟
مصرفکنندگان ممکن است آخرین revision مشاهدهشده را به خاطر بسپارند و با watch منتظر رویدادهای بعدی باشند. وقتی snapshot قدیمی برگردد، شمارنده تاریخی داده از دید آن مصرفکننده عقب میرود. حتی اگر محتوای کلیدها درست به نظر برسد، cache یا watch بلندمدت ممکن است برداشت درستی از تغییر نداشته باشد. این مسئله نشان میدهد سلامت ذخیرهسازی با سلامت همه مصرفکنندگان برابر نیست. بازیابی باید رفتار برنامههای متکی به revision را نیز در نظر بگیرد.
راهنمای رسمی بازیابی برای سناریوهای مربوط، سازوکار افزایش revision و علامتگذاری فشردهسازی را توضیح میدهد تا مصرفکنندگان مجبور به بازخوانی وضعیت شوند. مقدار و گزینه دقیق باید از مستندات همان نسخه و نرخ تغییر سامانه انتخاب شود؛ یک عدد کپیشده از مثال را برای همه محیطها مناسب ندانید. هدف، ایجاد فاصله کافی از revisionهایی است که پیش از حادثه دیده شدهاند و واداشتن cacheها به بازسازی صحیح. این تغییر داده گمشده پس از snapshot را دوباره ایجاد نمیکند.
تمرین در محیط جدا
برای تمرین، خوشهای آزمایشی با چند کلید دارای معنای مشخص بسازید. وضعیت اول را پشتیبان بگیرید، سپس یک کلید تازه اضافه و یکی را تغییر دهید. اکنون restore را در شبکهای جدا انجام دهید و نشان دهید کدام وضعیت برگشته و کدام تغییر عمداً وجود ندارد. یک مصرفکننده watch نیز در آزمایش داشته باشید تا رفتار revision فقط در سطح فایل بررسی نشود. نتیجه باید شامل محتوای کلیدها، سلامت endpointها و رفتار بازاتصال مصرفکننده باشد.
اگر etcd پشت Kubernetes است، بعد از بازیابی صرفاً آماده شدن endpointها کافی نیست. باید مشاهده کنید کنترلگرها دوباره وضعیت را میخوانند، API پاسخ مناسب میدهد و اشیای مورد انتظار با واقعیت بارهای کاری سازگارند. ممکن است منابعی پس از زمان snapshot در محیط بیرونی ساخته شده باشند که اکنون در داده کنترلپلین دیده نمیشوند. این ناسازگاری نیازمند تطبیق آگاهانه است. حذف یا ایجاد خودکار منابع بدون بررسی میتواند حادثه دوم بسازد.
ترتیب عملیاتی و کنترل نوشتن
پیش از restore، مسیرهای نوشتن به خوشه قدیمی را کنترل کنید تا دو منبع فعال برای تغییر وضعیت وجود نداشته باشد. مصرفکنندگان باید به مجموعه endpointهای مشخص هدایت شوند. اگر DNS یا پیکربندی مشتری تغییر میکند، زمان cache و رفتار retry را در نظر بگیرید. باز شدن پورت جدید نشان نمیدهد همه مشتریان مقصد تازه را شناختهاند. در بازه انتقال، اتصال به نشانیهای قبلی و خطاهای احراز هویت را زیر نظر بگیرید.
گواهیهای peer و client را نیز با نامها و نشانیهای بازیابی تطبیق دهید. خطای TLS در مرحله راهاندازی میتواند شبیه خرابی خوشه دیده شود، در حالی که داده سالم است. تاریخ انقضا، مرجع اعتماد و نامهای مجاز باید بررسی شوند. کلیدهای حساس را در دستورهایی که وارد تاریخچه shell یا لاگ عمومی میشوند چاپ نکنید. بهتر است مشخصات غیرمحرمانه و مسیر فایلها ثبت شود و خود اعتبارنامه در محل کنترلشده باقی بماند.
پذیرش نتیجه و نگهداری شواهد
یک بازیابی موفق باید با داده قابل بررسی اثبات شود: تعداد و نمونه کلیدهای مورد انتظار، سلامت اعضا، توان نوشتن و خواندن آزمایشی و بازگشت مصرفکنندگان. زمان صرفشده برای تهیه محیط، restore و بازسازی cache را جدا اندازه بگیرید. اگر فقط زمان اجرای ابزار را گزارش کنید، زمان واقعی بازگشت سرویس پنهان میماند. همین اندازهگیری به تعیین منابع و ترتیب کار در حادثه بعدی کمک میکند.
پس از پذیرش، پشتیبان تازه تهیه و restore آن را نیز طبق برنامه اعتبارسنجی کنید. دلیل حادثه اولیه، آخرین نقطه سالم و میزان داده از دسترفته باید ثبت شوند. اگر مشکل دیسک یا شبکه حل نشده باشد، برگرداندن داده به همان محیط میتواند دوباره شکست بخورد. نگهداری snapshot بدون تمرین، صرفاً امید به بازیابی است؛ تمرین باید هم فایل، هم هویت خوشه و هم رفتار مصرفکننده را پوشش دهد تا واقعاً قابل اتکا باشد.
در برنامه پشتیبان، پاک شدن تصادفی یک کلید را نیز تمرین کنید. خرابی همیشه از دست رفتن کل دیسک نیست و بازگرداندن کل snapshot برای یک اشتباه محدود میتواند تغییرات سالم دیگر را عقب ببرد. پیش از انتخاب روش، اثر بازیابی روی تمام مصرفکنندگان را بسنجید و مشخص کنید آیا اصلاح محدود داده با شواهد معتبر امکانپذیر است. انتخاب باید به معنای داده و دامنه حادثه متکی باشد، نه فقط در دسترس بودن یک فایل پشتیبان.


