
مسئله: پرسوجوی سنگین در کنار ورود پیوسته داده
Grafana Mimir برای نگهداری و پرسوجوی متریکها در مقیاس بزرگ طراحی شده است. در معماری Ingest Storage، Kafka یا سامانه سازگار با آن میان مسیر ورود داده و مسیر آمادهسازی داده برای خواندن قرار میگیرد. مستندات این معماری را از نسخه 3.0 پایدار و ترجیحی معرفی میکنند؛ معماری کلاسیک همچنان مفهوم جداگانهای دارد.
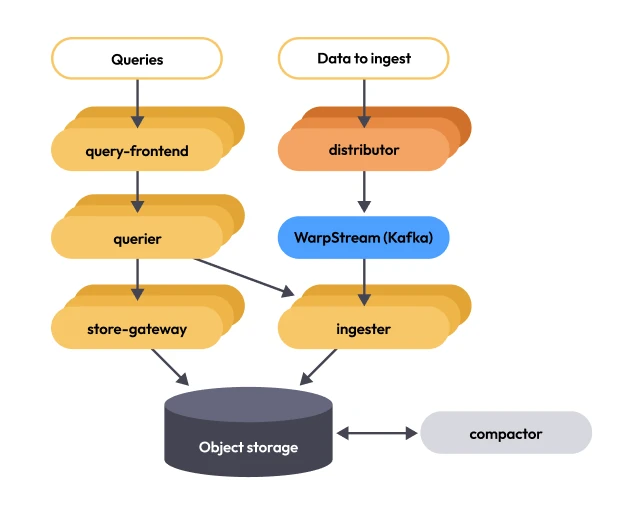
Distributor درخواست ورودی را اعتبارسنجی و به partitionهای مربوط هدایت میکند. Kafka داده را طبق تنظیمات ماندگاری و تکثیر ثبت میکند. Ingesterها سپس از این مسیر میخوانند و داده را برای پرسوجو آماده میکنند. نمودار همراه مقاله از همین صفحه رسمی گرفته شده است.
ثبتشدن با دیدهشدن فوری یکی نیست
جداشدن مسیرها کمک میکند فشار خواندن و نوشتن بهتر از هم تفکیک شود، اما باید فاصله رسیدن داده به مسیر خواندن نیز دیده شود. تأیید دریافت داده را با ظاهرشدن بدون تأخیر آن در هر پرسوجو یکسان فرض نکنید.
سناریوی ارزیابی پیشنهادی
برای یک محیط فرضی، نرخ تولید متریک را ثابت نگه دارید و همزمان چند پرسوجوی سنگین ایجاد کنید. سپس زمان پذیرش نوشتن، عقبماندگی مصرف و زمان پاسخ خواندن را جدا ثبت کنید. اگر فقط نمودار مصرف CPU را ببینید، ممکن است تأخیر واقعی دیدهشدن داده را از دست بدهید.
در آزمون دوم، یک مؤلفه مصرفکننده را موقتاً متوقف کنید و بازگشت آن را بسنجید. سؤال مهم این است که سامانه پس از بازگشت، با چه سرعتی عقبماندگی را جبران میکند و چه ظرفیتی برای آن لازم دارد. این آزمون باید در محیط غیرعملیاتی و با حد مشخص انجام شود.
مرز اعتماد و هزینه
شناسه مستأجر جای احراز هویت را نمیگیرد؛ کنترل دسترسی باید در مسیر ورودی قابلاعتماد اجرا شود. همچنین افزایش cardinality میتواند هزینه را بالا ببرد حتی وقتی تعداد ماشینها ثابت است. پیشنهاد تحریریه، تعریف سقفهای هر مستأجر و سیاست برچسبگذاری پیش از گسترش استقرار است؛ نام کاربر یا شناسه هر درخواست معمولاً گزینه مناسبی برای برچسب متریک نیست.
مسیر نوشتن را به چند نقطه قابل مشاهده تقسیم کنید
در یک استقرار فرضی، عامل جمعآوری متریک نمونهها را با زمان و مجموعه برچسبها ارسال میکند. در ورودی، هویت مستأجر و اعتبار داده بررسی میشود و سپس داده وارد مسیر ذخیره ورودی میشود. از این نقطه به بعد، آماده شدن داده برای پرسوجو کار جداگانهای است. اگر نمودار آخرین دقیقه خالی باشد، نخست باید بدانید نمونه اصلاً ارسال شده، پذیرفته شده یا هنوز در مسیر مصرف قرار دارد. بررسی تنها رابط گرافیکی نمیتواند این سه وضعیت را از هم جدا کند.
یک متریک آزمایشی با تغییر قابل تشخیص بسازید و زمان تولید آن را ثبت کنید. سپس زمان تأیید ارسال و نخستین زمانی که همان نمونه در پرسوجو دیده میشود اندازه بگیرید. اختلاف این زمانها را در بار عادی و هنگام فشار کنترلشده مقایسه کنید. این آزمایش آموزشی، تأخیر مشاهدهپذیری داده را از تأخیر پاسخ پرسوجو جدا میکند. ممکن است پرسوجو سریع پاسخ بدهد اما داده تازه هنوز به مسیر خواندن نرسیده باشد.
صف پایدار جای ظرفیت مصرف را نمیگیرد
قرار گرفتن سامانه ثبت ورودی میان تولید و مصرف میتواند وقفه کوتاه را جذب کند، ولی ظرفیت نامحدود ایجاد نمیکند. اگر نرخ ورود برای مدت طولانی از نرخ پردازش بیشتر باشد، عقبماندگی افزایش مییابد. فضای لازم برای نگهداری و زمان جبران نیز بیشتر خواهد شد. طراحی ظرفیت باید علاوه بر بار عادی، توان مصرف اضافی پس از وقفه را در نظر بگیرد؛ مصرفکنندهای که دقیقاً هماندازه نرخ تولید کار میکند هیچگاه عقبماندگی ایجادشده را جبران نخواهد کرد.
برای یک تمرین، مدت توقف کوتاه و حجم داده مجاز را از قبل تعیین کنید. پس از بازگشت مصرفکننده، نرخ کاهش عقبماندگی را اندازه بگیرید و بررسی کنید آیا فشار بازیابی بر منابع دیگر اثر دارد. اگر همزمان پرسوجوهای سنگین اجرا شوند، رفتار ممکن است با آزمایش بدون خواندن تفاوت کند. نتیجه را به همان بار و محیط محدود کنید و از تبدیل یک مشاهده کوچک به ادعای ظرفیت عمومی محصول پرهیز کنید.
مدت نگهداری داده در سامانه ورودی نیز باید با بدترین توقف قابل تحمل سازگار باشد. اگر مصرفکننده بیش از آن مدت عقب بماند، فرض امکان خواندن همه نمونههای گذشته ممکن است دیگر درست نباشد. هشدار باید پیش از رسیدن به چنین مرزی فعال شود و برای تیم عملیات اقدام مشخص داشته باشد. عدد عقبماندگی بدون توجه به مدت نگهداری و سرعت جبران، شدت خطر را به خوبی نشان نمیدهد.
cardinality از تعداد میزبان مهمتر میشود
هر ترکیب متفاوت برچسبها یک سری زمانی جدا میسازد. اضافه کردن برچسبی با مقدار تقریباً یکتا، مانند شناسه درخواست، میتواند تعداد سریها را بسیار بیشتر کند حتی اگر نرخ درخواست یا تعداد ماشینها ثابت باشد. این مسئله تنها مصرف دیسک نیست؛ نگهداری وضعیت، پردازش ورودی و اجرای پرسوجو نیز تحت تأثیر قرار میگیرند. پیش از افزودن برچسب تازه، تعداد مقادیر ممکن و ترکیب آن با برچسبهای موجود را تخمین بزنید.
برای مثال، برچسب مسیر واقعی شامل شناسه سفارش با برچسب الگوی مسیر یکسان نیست. الگوی «نمایش سفارش» میتواند برای سنجش عملکرد کافی باشد، در حالی که مسیر جداگانه برای هر سفارش سریهای فراوانی میسازد. اطلاعات موردی را در گزارش یا رهگیری نگه دارید و متریک را برای اندازهگیری تجمیعی طراحی کنید. این تقسیم مسئولیت کمک میکند ابزارها هر کدام داده مناسب خود را حمل کنند و هزینه برچسبها قابل توضیح بماند.
برای هر مستأجر سهم و حد مناسب تعریف کنید تا یک تغییر اشتباه در یک برنامه همه محیط را تحت فشار نگذارد. رد شدن نمونه بر اثر محدودیت باید قابل مشاهده باشد و مالک تولیدکننده آن را دریافت کند. صرف پایین آمدن بار سامانه پس از رد داده، موفقیت نیست؛ ممکن است دید عملیاتی یک تیم از بین رفته باشد. هشدار باید هم از سلامت زیرساخت و هم از کامل بودن داده لازم برای کاربران مراقبت کند.
خواندن، بازه زمانی و هزینه پرسوجو
پرسوجویی که یک سری مشخص در چند دقیقه را میخواند با پرسوجویی که هزاران سری را در چند ماه تجمیع میکند هزینه یکسان ندارد. هنگام شکایت از کندی، متن پرسوجو، بازه زمانی، گام زمانی و تعداد سریهای درگیر را ثبت کنید. تغییر چند متغیر همزمان نتیجه را مبهم میکند. ابتدا همان پرسوجو را با بازه محدودتر بررسی کنید و سپس عامل پرهزینه را پیدا کنید. افزایش منابع بدون اصلاح یک انتخاب بسیار گسترده همیشه راه اقتصادی یا پایدار نیست.
قواعد ثبت نتیجه میتوانند برای محاسبات پرتکرار مفید باشند، اما باید معنای داده و زمان ارزیابی آنها روشن باشد. اگر یک تجمیع برای داشبورد و هشدار مشترک استفاده شود، تغییر آن ممکن است هم نمایش و هم رفتار هشدار را عوض کند. نسخهبندی تعریف قواعد و آزمون با نمونه داده شناختهشده کمک میکند خطای معنایی از خطای زیرساخت تفکیک شود. سریع بودن پاسخ زمانی ارزش دارد که عدد پاسخ همان چیزی باشد که کاربر انتظار دارد.
هویت مستأجر و حفاظت از مسیر ورودی
در یک سرویس چندمستأجری، شناسه مستأجر باید از مسیر مورد اعتماد به سامانه برسد. اگر کاربر بتواند آزادانه شناسه را تغییر دهد، وجود برچسب یا سربرگ به تنهایی جداسازی امنیتی ایجاد نمیکند. لایه احراز هویت باید رابطه کاربر و مستأجر را تعیین کند و دسترسی مستقیم به مسیر داخلی نیز محدود باشد. آزمون منفی مناسب این است که حساب یک تیم نتواند با تغییر درخواست، داده تیم دیگر را بخواند یا برای آن داده بنویسد.
رازهای ارسال متریک را از فایلهای گزارش و مخزن کد دور نگه دارید و برای چرخش آنها برنامه داشته باشید. در زمان چرخش، صف محلی عامل و رفتار تلاش مجدد را بررسی کنید تا قطعی کوتاه احراز هویت به از دست رفتن طولانی داده منجر نشود. همچنین پاسخ خطا را دستهبندی کنید: تلاش مجدد بیوقفه برای اعتبارنامه باطل معمولاً مسئله را حل نمیکند و میتواند فشار اضافی بسازد. مالک اعتبارنامه باید مسیر روشن اصلاح داشته باشد.
مهاجرت را با برابری نتیجه بسنجید
اگر معماری موجود به مسیر جدید منتقل میشود، تنها پذیرش نوشتن کافی نیست. مجموعهای از داشبوردها، هشدارها و پرسوجوهای اصلی را انتخاب کنید و نتیجه آنها را در بازه یکسان مقایسه کنید. اختلاف ممکن است از تأخیر ورود، تنظیم زمان، داده تکراری یا تفاوت قواعد ناشی شود. پیش از اعلام موفقیت، علت اختلافهای مؤثر را روشن کنید. برای داده تاریخی نیز مشخص کنید کدام بخش از کدام مسیر خوانده میشود و چه زمانی انتظار یکپارچگی دارید.
برنامه بازگشت باید به دادههای نوشتهشده بعد از شروع مهاجرت توجه کند. برگشت صرف تنظیمات همیشه به معنای برگشت کامل وضعیت نیست. از ابتدا تصمیم بگیرید در صورت شکست، داده جدید چگونه حفظ یا دوباره وارد میشود و کدام وقفه برای کاربران قابل قبول است. این تصمیم معماری با روش استقرار و نسخه اجزا ارتباط دارد و باید از مستندات همان انتشار استخراج شود. نمودار معماری راهنمای درک مسئولیتهاست؛ جای طرح بازیابی مخصوص محیط شما را نمیگیرد.
یک داشبورد عیبیابی با پرسشهای روشن
برای بررسی این معماری، هر نمودار باید به پرسش مشخصی پاسخ دهد. نرخ ورودی نشان میدهد چه مقدار کار وارد سامانه میشود؛ خطای پذیرش میگوید چه بخشی رد شده است؛ عقبماندگی مسیر مصرف فاصله پردازش را نشان میدهد؛ و تأخیر پرسوجو تجربه خواننده را توصیف میکند. کنار هم گذاشتن این چهار گروه، از نتیجهگیری صرف بر اساس مصرف پردازنده جلوگیری میکند. اگر نرخ ورودی افت کرده ولی خطاهای عامل افزایش یافتهاند، آرام شدن سرور ممکن است نتیجه قطع داده باشد.
در یک تمرین آموزشی، ابتدا یک پرسوجوی ثابت و کمهزینه را به عنوان شاهد نگه دارید. سپس فقط بازه یک پرسوجوی دیگر را افزایش دهید و اثر آن را بر شاهد، مسیر نوشتن و تازه بودن نمونهها بررسی کنید. اگر همه شاخصها با هم تغییر کنند، هنوز لازم است محل رقابت منابع مشخص شود. نتیجه را با زمان دقیق و تنظیمات همان آزمایش ثبت کنید تا مقایسه بعدی معتبر باشد.
از ایجاد هشدار برای هر نوسان کوتاه پرهیز کنید، اما هشدار را صرفاً برای کم شدن پیامها خاموش نکنید. آستانه باید با مدت قابل قبول تأخیر داده و زمان لازم برای اقدام هماهنگ باشد. مالک هشدار باید بداند ابتدا وضعیت عامل، مسیر ورودی یا مصرفکننده را بررسی کند. این ارتباط میان نشانه و اقدام، داشبورد را از مجموعه نمودارهای زیبا به ابزار عملیات تبدیل میکند.


