
مسئله را از معماری شروع کنیم
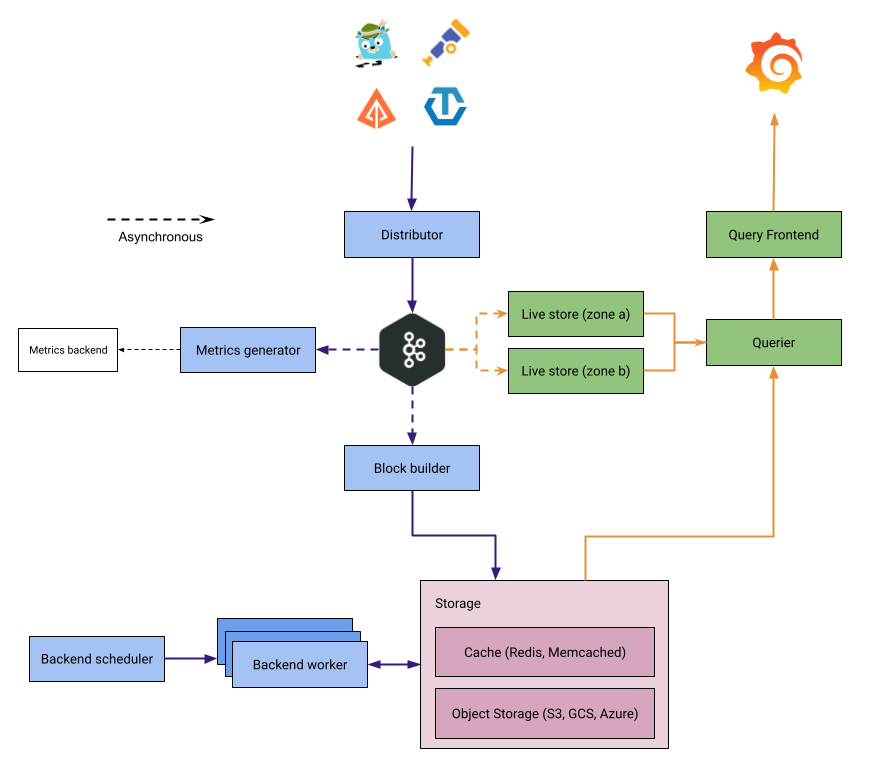
Tempo spanها را از protocolهای tracing میگیرد، آنها را distribute/ingest میکند و blockها را در object storage نگه میدارد. query path برای پیدا کردن trace و correlation با metric/log از مسیر نوشتن جداست.
موضوعهای زیرساختی زمانی قابل اتکا میشوند که مدل ذهنی قبل از command شکل بگیرد. componentها، state پایدار، state runtime، مرز اعتماد و dependency بیرونی را روی یک نقشهٔ ساده مشخص کنید. وقتی failure رخ میدهد، از ورودی به خروجی حرکت کنید و در هر مرز evidence جمع کنید؛ log، metric، API state و packet capture باید یک timeline مشترک بسازند.
روش عملی پیادهسازی
Trace ID را بین serviceها propagate کنید، resource attributeهای پایدار بسازید و sampling را براساس هزینه و نیاز incident تنظیم کنید. Collector را بهعنوان buffer/processor مستقل از application نگه دارید.
برای Production همیشه baseline، canary و rollback داشته باشید. baseline شامل نسخه، config مؤثر، latency یا throughput اصلی و یک test end-to-end سالم است. بعد از تغییر، test مثبت و منفی را تکرار کنید و نتیجه را با همان baseline مقایسه کنید. اگر success criterion از قبل نوشته نشده باشد، هر نتیجهای را میتوان موفق تفسیر کرد.
ریسکها و خطاهای رایج
Sampling تهاجمی ممکن است دقیقاً trace incident نادر را حذف کند. attribute پرکاردینالیتی، PII و payload حساس نیز نباید بدون policy وارد telemetry شوند.
امنیت عملیاتی یعنی کنترل قابل توضیح و قابل مشاهده. permission، token، secret، network path و audit trail را جدا بررسی کنید. exceptionها باید owner و expiry داشته باشند. اگر کنترل فقط روی کاغذ وجود دارد ولی اثر آن در runtime قابل اثبات نیست، در زمان incident بهجای کمک به مانع تبدیل میشود.
آزمایشگاه پیشنهادی
سه service آزمایشی با OpenTelemetry بسازید، latency مصنوعی در service دوم ایجاد کنید و trace end-to-end را در Tempo پیدا کنید. سپس sampling را تغییر و اثر را مقایسه کنید.
در Lab یک failure کنترلشده هم ایجاد کنید. هدف فقط اثبات happy path نیست؛ باید ببینید alert، log و recovery هنگام خرابی چه رفتاری دارند و آیا تیم میتواند بدون حدس علت را پیدا کند.
عیبیابی بر اساس Evidence
ابتدا مشخص کنید آخرین مرحلهای که رفتار صحیح دیده میشود کجاست. سپس فقط یک مرز جلو بروید. اگر request وارد component میشود اما state خروجی ساخته نمیشود، مسئله در همان component یا dependencyهای نزدیک آن است. تغییر همزمان چند config دامنهٔ مسئله را بزرگ میکند.
امنیت و Least Privilege
دسترسیها را براساس operation واقعی workload بدهید، نه براساس راحتی troubleshooting. credentialها را کوتاهعمر و قابل revoke نگه دارید، مسیرهای مدیریتی را از data plane جدا کنید و audit را طوری بسازید که بتوانید actor و زمان تغییر را بازسازی کنید.
Performance و ظرفیت
Average بهتنهایی کافی نیست. p95/p99، saturation، queue depth، retry و resource pressure را ثبت کنید. workload واقعی ممکن است bottleneck متفاوتی از Lab کوچک نشان دهد؛ بنابراین rollout را مرحلهای کنید و ظرفیت را با margin طراحی کنید.
Production readiness
owner، blast radius، change window، success metric و rollback trigger را قبل از rollout بنویسید. dependency خارجی را عمداً unavailable کنید، restart واقعی و credential rotation را تست کنید و بعد از deploy چند روز دوباره metric و ticketها را مرور کنید.
Runbook و انتقال دانش
Runbook خوب فقط command نیست. سؤال، فرضیه، evidence مورد انتظار، نتیجه و دلیل تصمیم را ثبت کنید. نفر دیگری باید بتواند با همان ورودی آزمایش را تکرار کند، failure را بازتولید و recovery را انجام دهد. این معیار ساده کیفیت واقعی documentation را نشان میدهد.
نگهداری بلندمدت
نسخه، policy، certificate، endpoint و حجم workload تغییر میکنند. برای همین review دورهای تعریف کنید: نسخهٔ پشتیبانینشده، exception قدیمی، alert بیارزش و drift را پیدا کنید. recovery را دوباره تمرین کنید و تاریخ review را در مستندات بنویسید.
تصمیم Production را با چه شواهدی بگیریم؟
قبل از اینکه نتیجهٔ Lab را به Production ببرید، یک change record کوتاه بسازید: مسئلهای که قرار است حل شود، وضعیت baseline، نسخه و config فعلی، dependencyهای درگیر، owner تغییر و دقیقاً چه metricی موفقیت را ثابت میکند. سپس یک canary انتخاب کنید که از نظر workload واقعی باشد اما blast radius محدودی داشته باشد. بعد از اعمال تغییر، فقط دنبال نبودن error نباشید؛ latency، throughput، queue، retry، saturation و تجربهٔ کاربر را با baseline مقایسه کنید. اگر feature امنیتی است، یک test منفی اجرا کنید تا مطمئن شوید مسیر غیرمجاز واقعاً بسته شده است. اگر feature availability است، dependency یا node را عمداً از دسترس خارج کنید و recovery واقعی را ببینید. تصمیم rollout باید براساس این evidence باشد، نه براساس اینکه dashboard سبز است یا command بدون خطا اجرا شده. هر rollout یک trigger صریح برای توقف و rollback داشته باشد. اگر نتیجه مبهم است، بهترین تصمیم معمولاً بزرگتر نکردن دامنه و جمعکردن evidence بیشتر است.
ظرفیت، Failure Domain و Recovery
سیستم در حالت سالم فقط نیمی از داستان است. مشخص کنید failure domain واقعی چیست: process، node، rack، zone، storage backend، network path یا provider. اگر چند replica دارید ولی همه روی یک failure domain هستند، redundancy ظاهری دارید نه availability واقعی. برای capacity نیز فقط مصرف فعلی CPU و RAM را نبینید؛ رشد داده، burst، compaction، retry storm و recovery traffic میتوانند در زمان incident چند برابر حالت عادی منابع بخواهند. RPO و RTO را به عدد تبدیل کنید و recovery را با stopwatch واقعی آزمایش کنید. اگر restore یا failover فقط در سند نوشته شده ولی هیچوقت اجرا نشده، هنوز قابلیت اثباتشدهای نیست. بعد از هر incident یا تمرین recovery، runbook و thresholdها را بازبینی کنید تا درس واقعی وارد سیستم شود.
Operational Ownership و چرخهٔ تغییر
هر component باید owner مشخص داشته باشد. owner فقط کسی نیست که deploy میکند؛ باید بداند alert به چه معناست، چه log یا dashboardی evidence اصلی است، dependencyها کداماند و چه زمانی escalation لازم است. تغییرهای config را در version control نگه دارید، peer review کنید و در صورت امکان validation را در CI قرار دهید. برای credential و certificate، expiry و rotation را قبل از حادثه تمرین کنید. برای سرویسهای stateful، schema/data migration را از binary rollout جدا ببینید. همچنین بعد از تغییر، یک بازهٔ observation تعریف کنید؛ بعضی failureها فقط پس از restart دوم، rotation token، compaction، cron job یا load واقعی ظاهر میشوند. Production readiness یک checkbox لحظهای نیست؛ چرخهای از deploy، observe، learn و اصلاح است.
سناریوی Incident و Recovery
یک سناریوی خرابی واقعی برای همین موضوع طراحی کنید و قبل از وقوع حادثه آن را تمرین کنید. ابتدا شرایط شروع را ثبت کنید: چه سرویسهایی سالماند، چه dependencyهایی در دسترساند، چه metric و logی baseline محسوب میشود و کاربر چه رفتاری میبیند. سپس فقط یک failure ایجاد کنید؛ مثلاً node را از دسترس خارج کنید، credential را revoke کنید، backend را کند کنید یا config ناسازگار deploy کنید. زمان کشف، زمان تشخیص، زمان تصمیم و زمان بازیابی را جدا ثبت کنید. بعد بررسی کنید آیا alert واقعاً actionable بوده یا فقط noise تولید کرده است. آیا log کافی برای یافتن root cause داشتید؟ آیا rollback به state قبلی برگشت یا state/data جدید مانع شد؟ آیا نفر دیگری غیر از سازندهٔ سیستم توانست runbook را اجرا کند؟ در پایان post-incident کوتاهی بنویسید که شامل علت فنی، ضعف فرایند، اقدام اصلاحی و owner باشد. هدف تمرین پیدا کردن مقصر نیست؛ هدف این است که failure بعدی ارزانتر، قابل مشاهدهتر و سریعتر قابل بازیابی باشد. همین تمرین ساده معمولاً شکافهایی را نشان میدهد که در review معماری یا dashboard سالم دیده نمیشوند.
جمعبندی IROSG
در موضوع معماری distributed tracing با Grafana Tempo هدف حفظ چند دستور نیست؛ هدف ساختن مدل ذهنی و evidence است. وقتی معماری را بفهمید و rollout قابل برگشت داشته باشید، ابزار یا نسخه میتواند عوض شود اما روش حل مسئله باقی میماند. مرجع اصلی این مطلب مستندات Grafana Tempo است.
چکلیست سریع
- مسئله را در یک جمله تعریف کن.
- معماری و مرز اعتماد را رسم کن.
- baseline را ذخیره کن.
- test مثبت و منفی بساز.
- canary اجرا کن.
- evidence را timestampدار نگه دار.
- rollback را تمرین کن.
- نتیجه را در runbook ثبت کن.
چرا یک Trace ممکن است ناقص دیده شود؟
برای دنبال کردن درخواست در چند سرویس، همه اجزا باید زمینه ردگیری را به شکل سازگار منتقل کنند. اگر سرویس ورودی شناسه را دریافت کند ولی هنگام فراخوانی سرویس بعدی آن را منتقل نکند، دو مسیر مستقل دیده میشود. این وضعیت با گم شدن داده در ذخیرهسازی فرق دارد. یک درخواست آزمایشی با شناسه مشخص بسازید و ابتدا ثبت span در برنامه، سپس دریافت در Collector و در نهایت نتیجه جستوجو را بررسی کنید. زمان شروع و پایان spanها نیز باید قابل اعتماد باشد؛ اختلاف ساعت میتواند تفسیر ترتیب رخدادها را دشوار کند.
نمونهبرداری را در تحلیل نتیجه لحاظ کنید. نبودن یک درخواست در رابط جستوجو لزوماً به معنای اجرا نشدن آن نیست؛ ممکن است در مرحله تولید یا پردازش انتخاب نشده باشد. اگر برای بررسی خطای نادر به نمونه بیشتری نیاز دارید، تغییر نرخ نمونهبرداری را محدود و زماندار انجام دهید و اثر آن بر حجم ورودی را بسنجید. افزایش ثبت داده بدون ظرفیت مناسب میتواند صفها را پر کند و نتیجه بررسی را بدتر کند. برای سناریوی آموزشی، ابتدا بار کوچک و قابل شمارش بسازید تا تعداد درخواست و تعداد ردهای قابل مشاهده قابل مقایسه باشند.
داده حساس و هزینه جستوجو
نام عملیات و ویژگیهای span باید برای فهم رفتار برنامه مفید باشند، اما ثبت بدنه کامل درخواست یا توکن ورود معمولاً ضروری نیست. یک نمونه داده را پیش از گسترش instrumentation مرور کنید و برای حذف یا پوشاندن ویژگیهای حساس تصمیم بگیرید. ذخیرهسازی ردها میتواند از نظر دسترسی و مدت نگهداری سیاست متفاوتی از لاگ معمولی داشته باشد. کاربری که امکان جستوجوی trace دارد ممکن است نام سرویسهای داخلی و مسیرهای درخواست را ببیند؛ این اطلاعات را در طراحی دسترسی لحاظ کنید.
در عیبیابی کندی جستوجو، بازه زمانی، شکل پرسوجو و حجم داده را همراه نتیجه ثبت کنید. یک پرسوجوی بسیار گسترده با پرسوجوی محدود به شناسه مشخص هزینه یکسان ندارد. همچنین سلامت دریافت داده با سلامت مسیر پرسوجو یکی نیست. اگر داده جدید قابل مشاهده نیست ولی رد قدیمی پیدا میشود، مسیر ورود و تأخیر آماده شدن داده را بررسی کنید؛ اگر هر دو شکست میخورند، وابستگی ذخیرهسازی و سرویس پرسوجو نیز مطرحاند. این تفکیک مانع راهاندازی دوباره بیهدف همه اجزای سامانه میشود.


