
چرا تعداد پیام میتواند سیگنال بهتری باشد؟
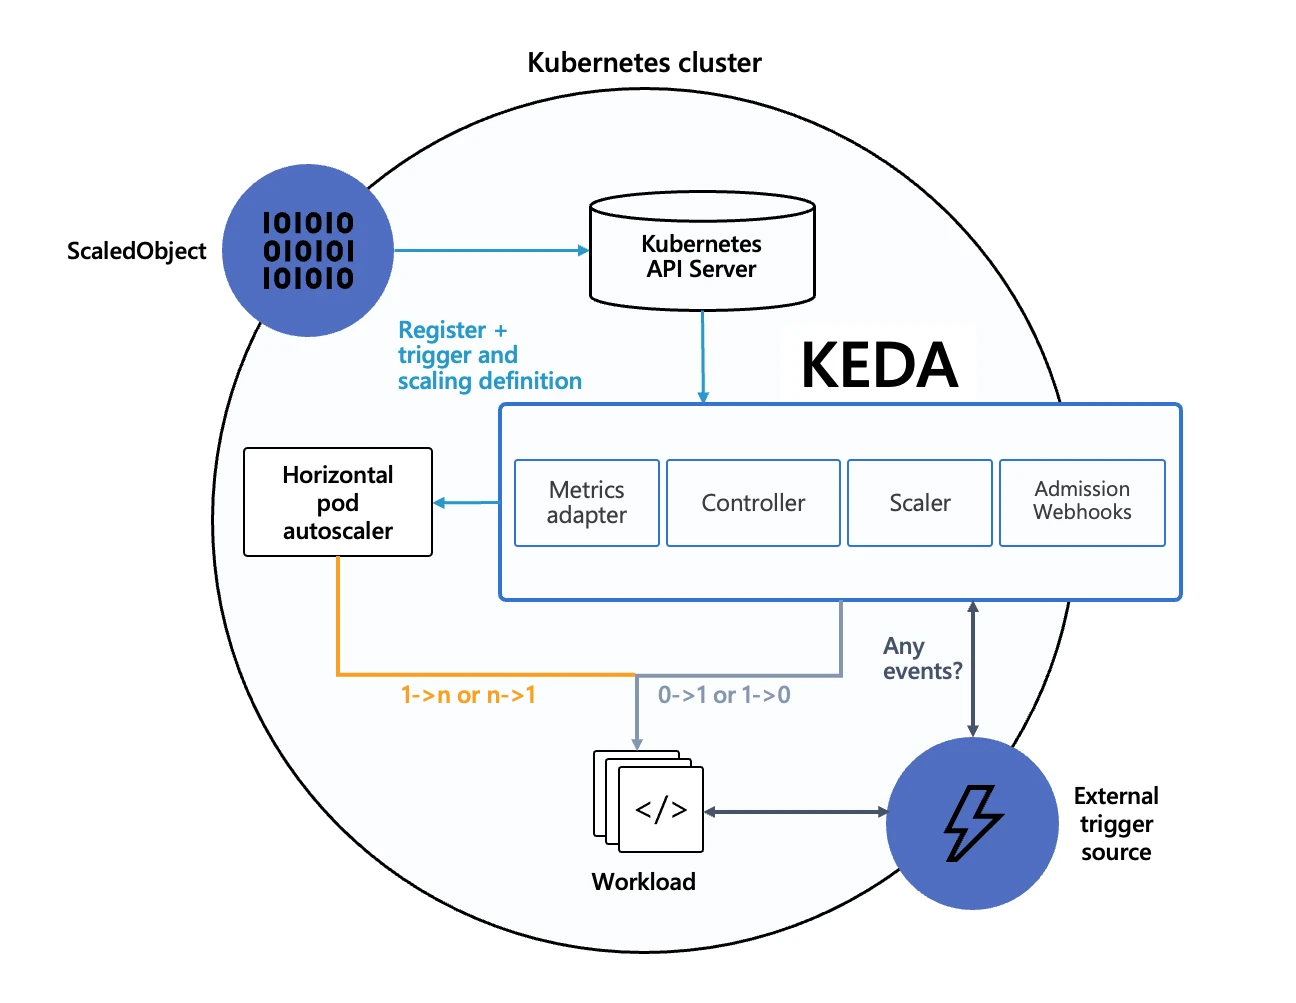
KEDA از سیگنال منابع رویداد برای مقیاسدهی بار کاری Kubernetes استفاده میکند. در معماری آن، Operator و بخش ارائه متریک با HPA همکاری میکنند. ScaledObject برای بارهای کاری مقیاسپذیر و ScaledJob برای الگوی Job به کار میرود. این دو شیء را نباید صرفاً دو نام متفاوت برای یک قرارداد دانست.
در الگوی رایج، KEDA فعالشدن بار کاری از صفر را مدیریت میکند و HPA از متریک ارائهشده برای تعیین تعداد replica استفاده میکند. جزئیات رفتار به Scaler و تنظیمات وابسته است. آستانه صف، فاصله بررسی، محدودیت replica و زمان آرامسازی باید با زمان شروع و توان مصرفکننده هماهنگ شوند.
سناریوی آموزشی مستقل
یک صف آزمایشی و مصرفکنندهای فرضی در نظر بگیرید که هر پیام را با تأخیر مشخص پردازش میکند. شناسه هر پیام و زمان ورودش را ثبت کنید. ابتدا تعداد مصرفکننده را ثابت نگه دارید و سپس مقیاسدهی را فعال کنید. نتیجه را با زمان انتظار قدیمیترین پیام و تعداد پیام تکمیلشده مقایسه کنید، نه فقط با تعداد Podها.
در مرحله بعد، ناگهان ورودی را زیاد کنید و ببینید برنامه چه مدت برای آمادهشدن نیاز دارد. اگر شروع هر نمونه طولانی است، بالا رفتن سقف replica بهتنهایی تأخیر ابتدای موج را حذف نمیکند. این مشاهده باید در تصمیم درباره حداقل ظرفیت آماده نقش داشته باشد.
خطای مهم: ظرفیت بیشتر، اثر درست نیست
پیشنهاد تحریریه، آزمایش قطع مصرفکننده پس از ثبت نتیجه و پیش از تأیید پیام است. آیا دریافت مجدد، عملیات تجاری را تکرار میکند؟ برای نمونه سفارش فرضی، شناسه رویداد و ثبت نتیجه را چنان طراحی کنید که بتوانید تکرار را تشخیص دهید. مقیاسدهی جای این قرارداد برنامه را نمیگیرد.
همچنین ظرفیت وابستگی پاییندستی را لحاظ کنید. دهها مصرفکننده ممکن است صف را سریعتر بخوانند اما پایگاه دادهای محدود را اشباع کنند. سقف مقیاس باید با ظرفیت کل مسیر تناسب داشته باشد.
دسترسی و نگهداری
برای اتصال Scaler به منبع متریک، کمترین مجوز لازم را انتخاب کنید و دسترسی خواندن وضعیت را از اختیار مدیریت صف جدا بسنجید. قطع دسترسی به منبع متریک نیز باید یک آزمون مستقل باشد: سامانه در نبود داده چه رفتاری دارد و چه کسی باخبر میشود؟ پیشنهاد ما ثبت مالک هر قاعده مقیاس و معیار بازبینی دورهای آن است.
آستانه صف را از توان مصرفکننده به دست آورید
برای تعیین آستانه، ابتدا یک مصرفکننده را با پیامهای نماینده اجرا کنید. زمان پردازش، تعداد عملیات همزمان و محدودیت وابستگیها را اندازه بگیرید. صفی با هزار پیام سبک با صفی دارای هزار کار چنددقیقهای یکسان نیست. اگر اندازه کارها بسیار متفاوت است، شمار پیام تنها شاخص تقریبی فشار خواهد بود. زمان انتظار قدیمیترین پیام و نرخ تکمیل میتوانند کمک کنند تا تصمیم مقیاسدهی با تجربه واقعی کاربر مرتبط شود.
در یک مثال فرضی، تیم میخواهد انتظار پیام از بودجه مشخصی فراتر نرود. ابتدا توان پایدار هر نمونه را در شرایط عادی به دست میآورد و سپس ظرفیت آماده لازم برای ورودی معمول را تعیین میکند. این اندازهگیری باید زمان اتصال اولیه، بارگیری تنظیمات و آمادهشدن برنامه را هم در نظر بگیرد. اگر Pod تازه دیر آماده میشود، فعالسازی از صفر برای هر الگوی بار مناسب نیست. انتخاب حداقل replica تصمیمی درباره هزینه و تأخیر است، نه مسابقه رسیدن به عدد صفر.
ScaledObject و HPA را یک زنجیره ببینید
ScaledObject به هدف مقیاسپذیر و triggerها اشاره میکند. KEDA وضعیت منبع رویداد را دریافت میکند و در مسیر متعارف، با HPA برای تعداد نمونهها همکاری میکند. پیش از عیبیابی، مشخص کنید مشکل در خواندن متریک است یا تصمیم مقیاس یا ساخت Pod آماده. اگر تعداد مطلوب بالا رفته ولی Podها در انتظار منابعاند، تغییر آستانه scaler کمبود ظرفیت خوشه را حل نمیکند. هر مرحله باید شاهد خودش را داشته باشد.
وجود چند کنترلکننده که یک تعداد replica را مستقل تغییر میدهند میتواند رفتار گیجکننده بسازد. قبل از افزودن KEDA، منابع فعلی مدیریت مقیاس را فهرست کنید. ابزار استقرار، GitOps و HPA نباید بدون قرارداد روشن مدام مقدار یکدیگر را بازنویسی کنند. در گزارش عیبیابی، مقدار مطلوب، مقدار واقعی و رخدادهای تغییر را کنار هم بگذارید تا معلوم شود چه کسی تصمیم گرفته است. فقط نگاه کردن به شمار Podها علت نوسان را آشکار نمیکند.
احراز هویت منبع متریک
Scaler معمولاً برای خواندن وضعیت منبع رویداد نیاز به دسترسی دارد. این اختیار را با اختیار حذف صف یا نوشتن پیام یکی نکنید. روش احراز هویت باید با scaler انتخابی و محیط شما سازگار باشد؛ ممکن است از secret یا هویت workload استفاده شود. مقدار محرمانه نباید در manifest عمومی یا خروجی عیبیابی چاپ شود. نام مرجع اعتبارنامه، دامنه اختیار و مالک چرخش آن را در مستندات ثبت کنید.
قطع اعتبارنامه را به عنوان خطای مجزا آزمایش کنید. اگر اتصال به صف شکست خورد، صفر گزارششده را با صفر واقعی صف اشتباه نگیرید. رفتار fallback و شرایط خطای scaler را طبق قابلیت همان منبع بررسی کنید. هدف آن است که نبود داده به تصمیم کاهش ظرفیت خطرناک منجر نشود. هشدار باید به فردی برسد که اختیار اصلاح دسترسی را دارد، نه فقط به تیم برنامه که شاید منبع متریک را اداره نمیکند.
مقیاسدادن با پردازش صحیح فرق دارد
وقتی تعداد مصرفکنندهها زیاد میشود، پیامها ممکن است همزمان و با ترتیب متفاوت پردازش شوند. اگر برنامه به ترتیب جهانی وابسته است، افزایش replica میتواند قرارداد آن را بشکند. ابتدا مشخص کنید ترتیب برای کل صف لازم است یا فقط برای پیامهای مربوط به یک مشتری یا کلید. طراحی partition، گروه مصرفکننده و سازوکار برنامه باید با این نیاز هماهنگ باشد. KEDA تعداد اجراها را مدیریت میکند و منطق تجاری ترتیب را ایجاد نمیکند.
تکرار پیام نیز باید انتظار طبیعی طراحی باشد. در آزمایش، مصرفکننده را پس از ثبت اثر در پایگاه و پیش از تأیید پیام متوقف کنید. اجرای بعدی ممکن است همان پیام را دریافت کند. برنامه باید با شناسه رویداد یا قرارداد مناسب از اثر تکراری جلوگیری کند. برای کارهایی مانند ارسال اعلان، نتیجه تکرار با عملیات مالی یکسان نیست؛ راهکار باید متناسب با اثر باشد. موفقیت مقیاسدهی بدون بررسی این سناریو فقط افزایش سرعت اجرای اشتباه است.
کاهش مقیاس و پایان آرام کار
کاهش تعداد نمونهها باید فرصت پایان یا واگذاری کار جاری را در نظر بگیرد. اگر Pod هنگام پردازش متوقف شود، رفتار صف در بازگرداندن پیام و زمان نامرئی بودن آن اهمیت دارد. برنامه باید سیگنال پایان را بفهمد، دریافت کار تازه را متوقف کند و کار جاری را طبق قرارداد تکمیل یا رها کند. زمان پایان مجاز در Kubernetes و زمان پردازش واقعی را کنار هم بررسی کنید تا توقف اجباری به حالت رایج تبدیل نشود.
در تمرین، یک کار طولانی و چند کار کوتاه را همزمان وارد کنید و اجازه دهید مقیاس کاهش یابد. شمار پیامهای تکمیلشده، تکرارشده و معطلمانده را ثبت کنید. این آزمایش مشکلاتی را نشان میدهد که در بار ثابت و فقط هنگام افزایش replica دیده نمیشوند. کاهش هزینه منابع زمانی ارزشمند است که بازیابی کار نیمهتمام قابل اعتماد بماند. اگر کارها خیلی طولانیاند، الگوی اجرای Job ممکن است قرارداد مناسبتری داشته باشد، اما انتخاب نیاز به بررسی معنای ScaledJob دارد.
سقف مقیاس باید کل مسیر را محافظت کند
افزایش مصرفکننده میتواند اتصالهای پایگاه داده، درخواستهای API و مصرف دیسک را چند برابر کند. یک سقف replica بدون محاسبه این وابستگیها ممکن است به جای تخلیه صف، خطای بیشتری تولید کند. برای هر نمونه تعداد اتصال و عملیات همزمان را تخمین بزنید و سپس با اندازهگیری واقعی تأیید کنید. محدودیت سرویس بیرونی نیز باید در این بودجه وارد شود؛ برنامه ممکن است CPU آزاد داشته باشد ولی به سقف مجاز درخواست مقصد رسیده باشد.
در بار جهشی، نرخ خطای پاییندستی را همزمان با طول صف رسم یا ثبت کنید. اگر با افزایش replica نرخ تکمیل بهتر نمیشود ولی خطا بالا میرود، محدودیت در جای دیگری است. کاهش یا کنترل همزمانی میتواند از افزودن منابع مؤثرتر باشد. این نتیجه را به عنوان رفتار خاص همین workload ثبت کنید، نه حکم عمومی علیه مقیاس افقی. آستانه مناسب با تغییر اندازه پیام یا نسخه برنامه دوباره نیاز به ارزیابی دارد.
برنامه آزمایش قابل تکرار
یک مجموعه پیام با شناسه یکتا و ترکیبی از اندازههای معمول آماده کنید. بار را در سه مرحله کم، جهشی و رو به کاهش اجرا کنید. در هر مرحله زمان ورود، شروع و پایان پیامها را ثبت کنید تا زمان صف از زمان پردازش جدا شود. سپس قطع کوتاه منبع متریک و نبود ظرفیت خوشه را جداگانه آزمایش کنید. تغییر همزمان چند عامل اجازه نمیدهد علت نتیجه را تشخیص دهید.
معیار پذیرش را پیش از اجرا بنویسید: حداکثر انتظار قابل قبول، نرخ خطای مجاز، رفتار پیام تکراری و زمان بازگشت به ظرفیت معمول. پس از پایان، تنظیمات مؤثر scaler و HPA را کنار نتیجه نگه دارید. نمودار تعداد replica به تنهایی سند موفقیت نیست؛ پیامهای درست و بهموقع پردازششده معیار اصلیاند. این روش کمک میکند تیم هزینه، تأخیر و صحت را در یک تصمیم مشترک ببیند.
پیام خراب و صف بنبست
یک پیام نامعتبر ممکن است هر بار شکست بخورد و دوباره وارد چرخه پردازش شود. در این وضعیت بالا رفتن تعداد مصرفکنندهها لزوماً پیشرفت ایجاد نمیکند و حتی فشار تکرار را بیشتر میکند. قرارداد تعداد تلاش، فاصله تلاشها و انتقال به صف بررسی جداگانه باید در برنامه یا سامانه صف روشن باشد. پیام ساختگی نامعتبر را وارد آزمایش کنید و ببینید آیا پیامهای سالم پشت آن متوقف میشوند یا همچنان پیش میروند.
برای پیامهای منتقلشده به مسیر بررسی، هویت، علت شکست و امکان بازپردازش کنترلشده لازم است. حذف خاموش آنها طول صف را بهتر نشان میدهد ولی داده کسبوکار را از بین میبرد. داشبورد موفقیت باید پیام تکمیلشده را از پیام کنارگذاشتهشده جدا کند. در نتیجه معیار مقیاسدهی نیز باید با نرخ پیشرفت واقعی بررسی شود. اگر صف کوتاه شده اما خطاها به مسیر دیگری منتقل شدهاند، نمیتوان صرفاً از روی طول صف نتیجه گرفت سامانه سالمتر شده است. این تمایز برای تصمیم درباره سقف replica و رسیدگی انسانی به خطاها ضروری است.


