
مدل کنترلی مشترک، محیط اجرای متفاوت
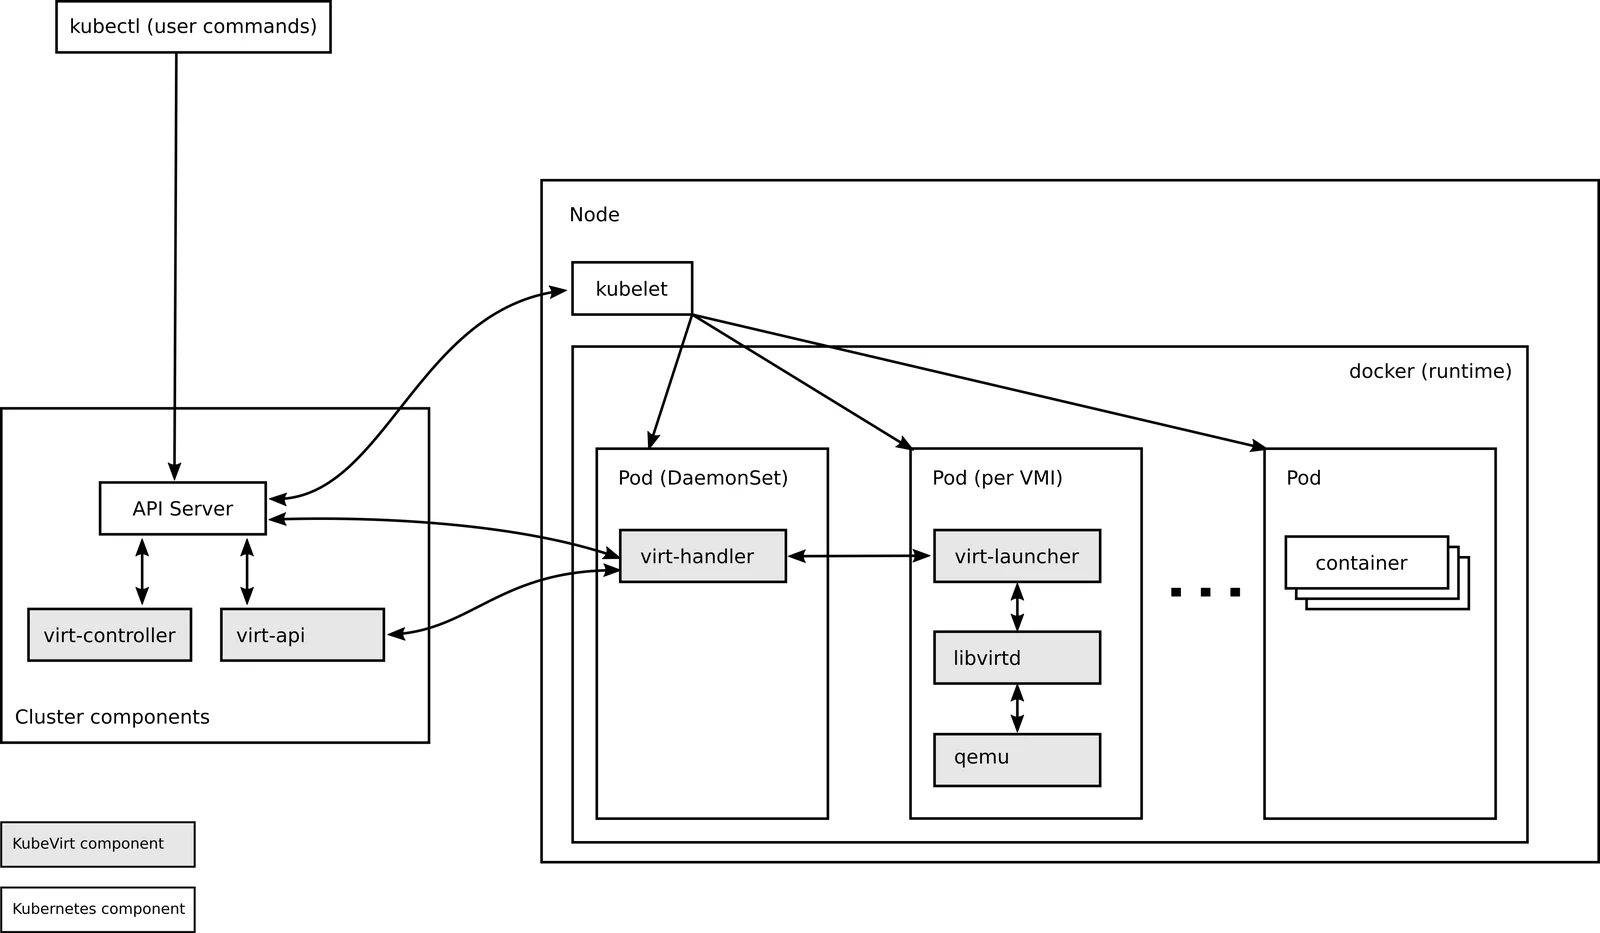
KubeVirt امکان اداره ماشینهای مجازی را با منابع و سازوکارهای Kubernetes فراهم میکند. در معماری آن، مؤلفههایی مانند virt-api، virt-controller، virt-handler و virt-launcher مسئولیتهای مختلف مدیریت و اجرای بار مجازی را بر عهده دارند. زیرساخت مجازیسازی همچنان به قابلیتها و محدودیتهای میزبان وابسته است.
منبع VirtualMachine وضعیت مدیریتی ماشین را توصیف میکند و VirtualMachineInstance به نمونه اجرای آن مربوط است. این تمایز در تحلیل توقف، راهاندازی مجدد و مشاهده وضعیت اهمیت دارد؛ یک تعریف موجود در API الزاماً به معنی وجود مهمان سالم و آماده خدمت نیست.
قرارگرفتن مدیریت VM در Kubernetes، نرمافزار داخل مهمان را خودکار به برنامه کانتینری تبدیل نمیکند. سیستمعامل مهمان، دیسک و سرویسهای آن همچنان چرخه نگهداری خود را دارند.
یک تمرین برای تیم مهاجرت
فرض کنید میخواهید یک سرویس قدیمی را بدون بازنویسی فوری، در کنار بارهای کانتینری اداره کنید. پیش از انتقال، وابستگیهای سرویس را ثبت کنید: نوع دیسک، نیاز شبکه، روش ورود مدیریتی و رفتار پس از خاموشی ناگهانی.
در محیط آزمایشی، اولین هدف را راهاندازی قابل تکرار مهمان قرار دهید. سپس سلامت سرویس داخل مهمان را از وضعیت منبع Kubernetes جدا بسنجید. ممکن است VM روشن باشد ولی سرویس کاربردی به علت تنظیم شبکه یا وابستگی خارجی در دسترس نباشد.
جابهجایی یک قابلیت مشروط است
امکان مهاجرت زنده به شرایط ذخیرهسازی، شبکه، قابلیت میزبان و تنظیمات وابسته است. پیش از وعده جابهجایی بدون اختلال، سازگاری همان سناریو را از مستندات انتشار نصبشده بررسی کنید. داشتن چند گره در خوشه، بهتنهایی نشاندهنده امکان انتقال هر ماشین نیست.
پیشنهاد تحریریه ساخت آزمونی با داده قابل بررسی است: یک عملیات پیوسته کمخطر اجرا کنید، جابهجایی مجاز را در محیط آزمایش انجام دهید و وقفه، خطا و وضعیت داده را ثبت کنید. فقط تغییر نام گره در داشبورد معیار پذیرش کافی نیست.
مسئولیتهای بعد از انتقال
مشخص کنید پشتیبان مهمان چگونه تهیه و بازیابی میشود، وصله سیستمعامل را چه کسی اعمال میکند و مجوز توقف یا تغییر ماشین در اختیار کدام نقش است. تفکیک تیم پلتفرم از مالک برنامه نباید باعث بیمالکشدن این کارها شود.
نمودار همراه از راهنمای رسمی KubeVirt است. آن را نقطه شروع شناخت اجزا بدانید؛ طراحی عملیاتی باید با سختافزار، بار کاری و محدودیتهای واقعی سازمان تکمیل شود.
ماشین مجازی در قالب منابع اعلامی
در یک بستر سنتی، مدیر ماشین مجازی را از رابط یک سامانه مجازیسازی ایجاد میکند. در KubeVirt، قصد اجرای ماشین با منابع Kubernetes بیان میشود و کنترلگرها برای تحقق آن تلاش میکنند. این شباهت مدیریتی به معنای تبدیل سیستمعامل مهمان به ظرف نیست. مهمان همچنان مدل ماشین مجازی، دیسک، حافظه و فرایند راهاندازی خود را دارد. Kubernetes مسئولیتهایی مانند زمانبندی و مدیریت منابع را فراهم میکند، در حالی که لایه مجازیسازی اجرای مهمان را انجام میدهد. شناخت این مرز برای عیبیابی ضروری است.
فرض کنید یک برنامه قدیمی فقط روی سیستمعامل مشخصی قابل اجراست و تیم میخواهد آن را کنار خدمات ظرفی اداره کند. استفاده از مدل مشترک دسترسی، شبکه و خودکارسازی میتواند مفید باشد، اما برنامه قدیمی ناگهان رفتار ابری پیدا نمیکند. خاموشی ناگهانی، نیاز به دیسک پایدار و محدودیت مجوز نرمافزار همچنان مطرحاند. پیش از مهاجرت، مشخص کنید هدف کاهش تعداد بسترهای مدیریتی است یا تغییر معماری برنامه. این دو پروژه دامنه و معیار موفقیت متفاوت دارند و نباید با یک نصب آزمایشی موفق یکی فرض شوند.
تعریف ماشین با اجرای جاری آن فرق دارد
یک منبع تعریفکننده ماشین میتواند قصد بلندمدت را نگه دارد، در حالی که نمونه اجرایی وضعیت فعلی آن را نشان میدهد. توقف و شروع دوباره ممکن است نمونه تازهای بسازد، بدون آنکه تعریف ماشین حذف شود. بنابراین برای فهم وضعیت، فقط وجود یک شیء را بررسی نکنید. رابطه تعریف، نمونه جاری و پاد اجراکننده را دنبال کنید. اگر نمونه ایجاد نشده، مسئله در مسیر کنترل یا سیاست اجراست؛ اگر پاد زمانبندی نشده، منابع گره و محدودیتهای زمانبندی مهماند؛ اگر مهمان بوت نمیشود، باید دیسک و کنسول مهمان را بررسی کرد.
در یک آزمایش ساده، ماشین کوچکی با دیسک آزمایشی بسازید، آن را شروع کنید و زنجیره منابع وابسته را ثبت کنید. سپس توقف عادی و شروع دوباره را انجام دهید. بررسی کنید کدام شناسهها عوض شده و کدام دادهها باقی ماندهاند. این مشاهده، تفاوت عمر ماشین منطقی، عمر فرایند اجرا و عمر دیسک را روشن میکند. اگر این سه عمر در ذهن تیم یکی باشند، احتمال حذف ناخواسته داده هنگام پاکسازی منابع موقت بالا میرود.
ظرفیت فقط جمع حافظه مهمانها نیست
هر ماشین علاوه بر منابع اختصاصیافته به مهمان، سربار اجرایی و مدیریتی دارد. گره نیز به منابعی برای سیستمعامل، شبکه، ذخیرهسازی و خدمات Kubernetes نیاز دارد. بنابراین نباید همه حافظه فیزیکی را صرف جمع اندازه مهمانها کرد. همچنین ویژگیهای پردازنده و دسترسی به شتابدهی سختافزاری باید با نیاز اجرا سازگار باشند. در محیط آزمایشگاهی تو در تو، رفتار میتواند با سرور واقعی فرق کند؛ نتیجه کندی یا موفقیت آن را بدون بررسی به تولید تعمیم ندهید.
برای برنامهای حساس به تأخیر، علاوه بر میانگین مصرف پردازنده، رقابت گره، زمان پاسخ دیسک و الگوی شبکه را اندازه بگیرید. اگر بارهای ظرفی و ماشینهای مجازی روی یک گره مشترکاند، فشار یکی میتواند دیگری را تحت تأثیر قرار دهد. سیاست منابع و جایگذاری باید از نیاز خدمت بیاید. ماشین بسیار بزرگ ممکن است در خوشه فضای آزاد مجموع داشته باشد، اما هیچ گره منفردی برای آن مناسب نباشد. در چنین وضعیتی افزایش تعداد گره کوچک لزوماً مشکل زمانبندی را حل نمیکند.
دیسک مهمان و مسیر آمادهسازی تصویر
تصویر سیستمعامل باید از منبع معتبر وارد و با روش مناسب به فضای ذخیره منتقل شود. انتقال یک فایل تصویر با آماده بودن دیسک برای اجرای همزمان یا مهاجرت یکسان نیست. قابلیتهای کلاس ذخیرهسازی، شیوه دسترسی حجم و عملکرد آن را بررسی کنید. اگر مهمان چند دیسک دارد، نقش هرکدام را ثبت کنید: دیسک سیستم، داده، موقت یا نصب. در آزمایش حذف و بازسازی ماشین، باید دقیقاً بدانید کدام دیسک حفظ میشود و کدام قابل بازتولید است.
اطلاعات اولیه مهمان مانند نام میزبان، کاربر و کلید دسترسی ممکن است هنگام نخستین راهاندازی تزریق شوند. این مرحله باید بدون قرار دادن گذرواژه آشکار در مخزن عمومی طراحی شود. همچنین تکرارپذیری را بسنجید: آیا استفاده دوباره از همان تصویر باعث تکرار شناسه ماشین، کلید میزبان یا تنظیم شبکه میشود؟ تصاویر طلایی باید برای ساخت نمونههای مستقل آماده شده باشند. نمونهای که در ظاهر بالا میآید اما هویت تکراری دارد میتواند بعداً در ثبت موجودی، احراز هویت یا شبکه مشکل ایجاد کند.
شبکه از دید مهمان و خوشه
نشانی داخل مهمان، نشانی پاد و نشانی قابل دسترسی خدمت ممکن است یکسان نباشند. روش اتصال شبکه تعیین میکند بسته چگونه از مهمان به شبکه خوشه و بیرون میرسد. پیش از عیبیابی، این مسیر را رسم کنید. آیا درخواست به خدمت Kubernetes میآید و سپس به مهمان میرسد؟ آیا مهمان به شبکه جداگانه متصل است؟ آیا ترجمه نشانی وجود دارد؟ پاسخ این پرسشها محل مناسب ثبت بسته و اعمال سیاست را مشخص میکند.
برای آزمون، ابتدا از داخل مهمان مقصد محلی و سپس مقصد بیرونی را بررسی کنید. در جهت ورودی نیز از یک مبدأ مشخص اتصال تازه بسازید. اگر فقط ارتباط یکطرفه کار میکند، مسیر برگشت و سیاست شبکه را بررسی کنید. دیوار آتش داخل مهمان را فراموش نکنید؛ اجازه در سطح خوشه به معنی اجازه در سیستمعامل مهمان نیست. برعکس، باز بودن درگاه مهمان، نبود مسیر یا محدودیت بیرونی را جبران نمیکند. ثبت شواهد در هر دو سوی مرز، از تغییر همزمان چند لایه جلوگیری میکند.
مهاجرت زنده نیازمند پیششرط است
امکان مهاجرت زنده را ویژگی خودکار همه ماشینها فرض نکنید. سازگاری پردازنده، شبکه، ذخیرهسازی و نوع دستگاههای متصل روی قابلیت و رفتار مهاجرت اثر میگذارند. دستگاه اختصاصی یا نوع خاص دسترسی دیسک میتواند محدودیت ایجاد کند. مستندات نسخه و وضعیت قابل مهاجرت بودن همان ماشین را بررسی کنید. مهاجرت در محیط بدون بار نیز کافی نیست؛ مهمان هنگام نوشتن و پاسخ به درخواست باید آزموده شود تا وقفه و اثر عملی روشن باشد.
در تمرین نگهداری گره، ابتدا ظرفیت مقصد را بررسی کنید و بعد مهاجرت کنترلشده یک ماشین کمخطر را انجام دهید. زمان عملیات، وقفه قابل مشاهده کاربر و وضعیت دیسک را ثبت کنید. اگر مهاجرت شکست خورد، از تکرار بیحد بدون فهم علت خودداری کنید؛ ممکن است محدودیت ساختاری وجود داشته باشد. تخلیه گره باید با سیاست دسترسپذیری خدمت هماهنگ باشد. انتقال فرایند اجرا به گره دیگر، جای طراحی افزونگی درون برنامه را نمیگیرد.
نسخه پشتیبان و عملیات داخل مهمان
پشتیبان منابع Kubernetes با پشتیبان سازگار داده داخل مهمان تفاوت دارد. پایگاه داده درون ماشین ممکن است برای نسخه قابل اعتماد به هماهنگی خاص نیاز داشته باشد. همچنین بهروزرسانی سیستمعامل و عاملهای داخل مهمان مسئولیت جداگانهای است. مدیریت ماشین از طریق Kubernetes به معنی رفع خودکار آسیبپذیریهای مهمان نیست. موجودی نسخهها، دسترسی کنسول و روش بازیابی مهمان باید در فرایند عملیات باقی بمانند.
برای تحویل، یک سناریوی خراب شدن سیستمعامل و یک سناریوی حذف تعریف ماشین را جدا تمرین کنید. در اولی باید بتوانید دیسک یا داده را بازیابی کنید؛ در دومی ممکن است تعریف اعلامی کافی باشد، به شرط آنکه دیسک سالم باقی مانده باشد. نتیجه را با آزمون خود برنامه تأیید کنید. معیار موفقیت این نیست که کنسول صفحه ورود نشان دهد؛ خدمت مورد نیاز کاربر باید با داده درست و دسترسی محدود به کار برگردد. این نگاه مانع آن میشود که یکپارچگی مدیریتی با تضمین کامل بازیابی اشتباه گرفته شود.
مالکیت عملیاتی میان دو تیم
اگر تیم زیرساخت خوشه را اداره میکند و تیم دیگری مسئول سیستمعامل مهمان است، مرز مسئولیت را روشن کنید. برای خطای پر شدن دیسک، انقضای گواهی داخل مهمان یا بهروزرسانی عامل شبکه، باید مالک مشخص وجود داشته باشد. دسترسی کنسول اضطراری نیز لازم است با حساب و ثبت رخداد کنترل شود؛ این دسترسی میتواند خارج از مسیر عادی ورود سیستمعامل عمل کند و نباید بدون بازبینی در اختیار همه مدیران برنامه باشد.
یک رخداد نمونه را از گزارش کاربر تا اصلاح دنبال کنید. مشخص کنید تیم نخست چه شواهدی جمع میکند و در چه نقطهای موضوع را به تیم دیگر میسپارد. ارسال صرف جمله «ماشین بالا است» کافی نیست؛ وضعیت شبکه، دیسک، مصرف منابع و خطای مشاهدهشده باید همراه انتقال باشد. این قرارداد کوچک از رفتوبرگشت طولانی تیکتها جلوگیری میکند. یکپارچه شدن بستر فنی تنها زمانی به ساده شدن عملیات کمک میکند که مسئولیتهای انسانی نیز به همان اندازه روشن و قابل اجرا باشند.


