
یک حجم، چند مؤلفه
Longhorn ذخیرهسازی بلوکی توزیعشده را برای بارهای کاری Kubernetes فراهم میکند. در مدل توضیحدادهشده در مستند مفاهیم، مؤلفههای مدیریت حجم و replicaها در کنار اتصال به Kubernetes قرار میگیرند. تکثیر داده بین گرهها به تحمل خرابی کمک میکند، اما انتخاب محل replica و ظرفیت واقعی دیسک همچنان مهم است.
اگر همه نسخهها در یک محدوده خرابی مشترک قرار بگیرند، تعداد بیشتر آنها الزاماً حفاظت موردانتظار را ایجاد نمیکند. سه گره روی یک میزبان فیزیکی یا یک منبع برق، از نظر خرابی مشترک با سه محدوده مستقل برابر نیستند.
Snapshot و Backup چه فرقی دارند؟
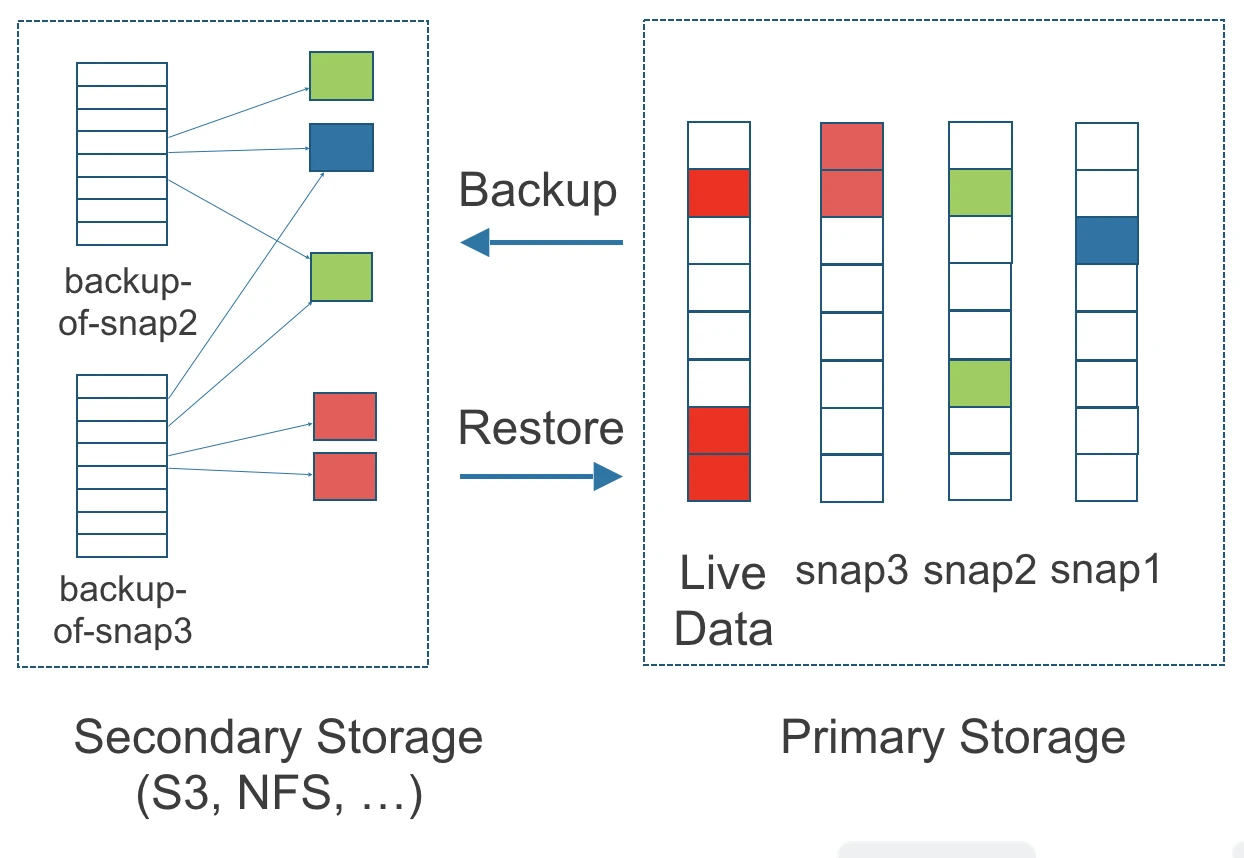
Snapshot نقطهای از وضعیت حجم را ثبت میکند؛ Backup مسیر نگهداری نسخه پشتیبان در مقصد پشتیبان را فراهم میسازد. نمودار اصلی همراه این مقاله، فرایند ایجاد Backup را نشان میدهد. وجود snapshot در همان سامانه را نباید به معنی داشتن نسخه مستقل خارج از آن سامانه دانست.
مثال آموزشی برای یک پایگاه داده
در یک محیط آزمایشی، یک رکورد مشخص ایجاد کنید و زمان ثبت آن را یادداشت کنید. سپس مطابق روش سازگار با برنامه، نسخه پشتیبان بگیرید و آن را روی حجم و نمونه جدا بازگردانید. معیار موفقیت، ساختهشدن نام حجم نیست؛ باید رکورد موردنظر خوانده شود و برنامه بتواند با داده بازیابیشده کار کند.
برای برنامهای که چند فایل یا چند حجم را با هم تغییر میدهد، درباره سازگاری داده در لحظه snapshot سؤال کنید. پیشنهاد تحریریه این است که روش پشتیبانگیری خود برنامه و نیاز به توقف یا هماهنگی نوشتن، بخشی از طراحی باشد؛ نه یک فرض پنهان در تنظیمات ذخیرهسازی.
شاخصهای مهم بهرهبرداری
ظرفیت آزاد، وضعیت replicaها، زمان بازسازی، موفقیت انتقال Backup و زمان بازیابی را جدا پایش کنید. یک سامانه ممکن است در لحظه سالم باشد اما فضای کافی برای بازسازی پس از خرابی نداشته باشد. همچنین چرخه نگهداری و حذف نسخههای قدیمی را مستند کنید تا کمبود فضا به یک رخداد دوم تبدیل نشود.
از درخواست ذخیرهسازی تا محل واقعی داده
برنامه معمولاً یک PersistentVolumeClaim درخواست میکند و انتظار دارد حجم مناسبی در اختیارش قرار گیرد. این درخواست لایه مصرف را نشان میدهد؛ ظرفیت دیسکهای میزبان و محل replicaها در لایه دیگری قرار دارند. برای فهم وضعیت یک پایگاه داده، نام PVC را به حجم Longhorn و سپس به replicaهای واقعی وصل کنید. اگر تنها ظرفیت اعلامشده در Kubernetes را نگاه کنید، ممکن است کمبود فضای محل نگهداری یا محدودیت جایگذاری را نبینید. جدول کوچکی از برنامه، حجم، گره متصل و محل نسخهها برای عملیات روزمره بسیار مفید است.
در انتخاب اندازه، تنها داده فعلی را حساب نکنید. رشد برنامه، فضای موقت عملیات، snapshotهای نگهداریشده و نیاز بازسازی نیز سهم دارند. یک حجم ظاهراً خالی میتواند تعهد ظرفیت ایجاد کند، در حالی که مصرف واقعی دیسک به الگوی نوشتن وابسته است. بنابراین نسبت ظرفیت منطقی به فضای فیزیکی باید همراه با سیاست هشدار بررسی شود. افزایش ظرفیت اعلامی بدون فضای کافی برای خرابی بعدی، تحمل خرابی را به فرضی خوشبینانه تبدیل میکند. برای سرویس مهم، آستانه عملیاتی باید پیش از پر شدن کامل فعال شود.
replica سالم چه چیزی را تضمین نمیکند؟
تکثیر بلوکی برای ادامه دسترسی در برابر بعضی خرابیهای زیرساختی مفید است. اگر برنامه فایل اشتباه را حذف کند یا داده نامعتبر بنویسد، همان تغییر میتواند در نسخههای دیگر نیز منعکس شود. پس چند replica جای تاریخچه مستقل را نمیگیرد. در طراحی، سه پرسش جدا داشته باشید: هنگام خراب شدن دیسک چه میشود، هنگام حذف اشتباه داده چه میشود و هنگام از دست رفتن کل خوشه چه میشود؟ پاسخ هر سه نباید فقط «سه نسخه داریم» باشد، چون نوع استقلال مورد نیاز در هرکدام متفاوت است.
محل نسخهها نیز باید با مدل خرابی سازمان هماهنگ باشد. اگر گرهها از یک ذخیرهساز زیرین مشترک استفاده میکنند، نامهای متفاوت گره به معنی دیسک مستقل نیست. اگر چند گره روی یک میزبان مجازی قرار دارند، خرابی میزبان همه را متاثر میکند. قبل از انتخاب تعداد نسخه، نقشه برق، شبکه و ذخیرهساز زیرین را بررسی کنید. این تحلیل از افزودن بیهدف replica مفیدتر است، زیرا نسخه اضافی هم فضای بیشتری میخواهد و هم در مسیر نوشتن و بازسازی هزینه دارد.
سازگاری snapshot برای داده کاربردی
Snapshot در سطح بلوک تصویری از وضعیت ذخیرهسازی میسازد، اما مفهوم تراکنش پایگاه داده را به تنهایی توضیح نمیدهد. برنامه ممکن است بخشی از تغییر را در حافظه داشته باشد یا چند فایل را با ترتیب مشخص بهروز کند. برای یک پایگاه داده، روش توصیهشده خود آن برنامه درباره پشتیبانگیری و بازیابی باید مبنا باشد. در آزمایش، فقط تعداد فایلها را مقایسه نکنید؛ پایگاه داده را از نسخه بازیابیشده راهاندازی کنید، بررسی سلامت منطقی انجام دهید و چند تراکنش شناختهشده را بخوانید.
اگر برنامه از چند حجم استفاده میکند، هماهنگی زمانی آنها اهمیت بیشتری پیدا میکند. بازگرداندن حجم داده از یک زمان و حجم گزارش تراکنش از زمان نامرتبط ممکن است بازیابی را پیچیده کند. یک روش عملی، تعریف نقطه مشخص پشتیبانگیری برنامه و ثبت وابستگی حجمهاست. اگر توقف نوشتن لازم است، مدت آن را اندازه بگیرید و برای زمانبندی مناسب استفاده کنید. ادعای «بدون توقف» باید به روش واقعی برنامه متکی باشد؛ حذف مرحله هماهنگی از مستندات، نیاز فنی را حذف نمیکند.
پشتیبان مستقل و آزمون مقصد
مقصد Backup باید از منظر خرابی و دسترسی با خوشه اصلی بررسی شود. مقصدی که تنها از همان حساب مدیریتی و همان محدوده تخریب قابل حذف است، ممکن است در برابر خطای مدیریتی استقلال کافی نداشته باشد. سیاست نگهداری، دسترسی حذف و هزینه ظرفیت را روشن کنید. برای هر کار پشتیبانگیری، زمان پایان، اندازه قابل انتظار و نتیجه انتقال را ثبت کنید. علامت موفقیت یک زمانبند بدون بررسی نسخه موجود در مقصد، برای اثبات امکان بازیابی کافی نیست.
تمرین بازیابی را روی حجم جدا انجام دهید تا داده فعال در خطر نباشد. زمان دریافت، ساخت حجم، اتصال و راهاندازی برنامه را جدا اندازه بگیرید. ممکن است بخش عمده زمان در انتقال شبکه باشد یا در بررسی خود پایگاه داده. این اعداد به تعیین هدف بازیابی کمک میکنند. اگر فقط زمان ساخت شیء حجم ثبت شود، برآورد بازگشت سرویس خوشبینانه خواهد بود. همچنین مطمئن شوید اعتبار دسترسی به مقصد و تنظیمات مورد نیاز در یک حادثه واقعی در دسترس تیم مجاز قرار دارند.
بازسازی پس از خرابی، یک بار کاری واقعی است
وقتی replica از دست میرود، بازسازی نسخه جایگزین از منابع شبکه و دیسک استفاده میکند. همان منابع در خدمت درخواستهای برنامه نیز هستند. بنابراین دوره بازسازی میتواند تأخیر برنامه را افزایش دهد، حتی اگر وضعیت سرویس قطع نشده باشد. در آزمایش ظرفیت، تنها حالت سالم را نسنجید؛ یک خرابی کنترلشده ایجاد کنید و زمان پاسخ برنامه را در دوره بازسازی دنبال کنید. نتیجه نشان میدهد آیا فضای آزاد و پهنای باند برای حفظ کیفیت سرویس در حالت کاهشیافته کافی هستند یا خیر.
از حذف و ساخت مکرر نسخهها به عنوان روش عمومی عیبیابی پرهیز کنید. نخست علت ناسالم شدن را پیدا کنید: خطای دیسک، قطع شبکه، فشار منابع یا محدودیت زمانبندی. اگر علت پابرجاست، بازسازی تازه نیز ممکن است شکست بخورد و بار بیشتری ایجاد کند. گزارش گره، وضعیت دیسک و رخدادهای حجم را روی یک خط زمانی قرار دهید. تفاوت میان «نسخه عقب افتاده» و «گره غیرقابل دسترس» در انتخاب اقدام بعدی مهم است و نباید در یک هشدار کلی گم شود.
تعمیرات و جابهجایی برنامه
پیش از خارج کردن گره از سرویس، بدانید کدام حجمها به آن متصلاند و replicaهای آن در کجا قرار دارند. قطع همزمان چند گره میتواند فرض تحمل خرابی را نقض کند. تعمیرات باید با وضعیت فعلی نسخهها هماهنگ باشد؛ اگر سامانه پیشاپیش کاهش افزونگی دارد، همان برنامه تعمیر معمول ممکن است خطرناک شود. پس از هر مرحله، آماده بودن نسخهها و امکان خواندن و نوشتن برنامه را بررسی کنید. تکمیل دستور تخلیه گره پایان ارزیابی داده نیست.
برای تغییر نسخه Longhorn نیز تفاوت موتور داده، پیشنیازهای سیستم و مسیر ارتقای پشتیبانیشده را از مستندات نسخه خود بخوانید. این مقاله عمداً عدد ثابت برای کارایی یا زمان بازیابی نمیدهد، زیرا نتیجه به دیسک، شبکه، نوع بار و تنظیمات وابسته است. گزارش داخلی بهتر است تعداد عملیات، اندازه نوشتن، تأخیر و وضعیت replicaها را کنار هم داشته باشد. چنین گزارشی بعداً امکان مقایسه یک تغییر را فراهم میکند و انتخاب معماری را از حدس یا تجربه نامرتبط جدا میسازد.
تصمیم درباره برنامه حساس به تأخیر
برای پایگاه دادهای که هر تراکنش نوشتن همگام دارد، تأخیر ذخیرهسازی مستقیماً بر تجربه کاربر اثر میگذارد. آزمون فایل بزرگ ترتیبی نمیتواند رفتار نوشتنهای کوچک و همگام را نمایندگی کند. از الگوی کاری خود برنامه استفاده کنید و تعداد اتصالها، اندازه داده و وضعیت حافظه نهان را ثبت کنید. مقایسه دو تنظیم بدون ثابت نگه داشتن این عوامل ممکن است نتیجه گمراهکننده بدهد. همچنین دوره سالم و دوره بازسازی را جدا گزارش کنید تا هزینه تحمل خرابی در تصمیم ظرفیت دیده شود.
در گزارش ظرفیت، تنها میانگین را ننویسید. اگر بیشتر تراکنشها سریعاند ولی تعدادی بسیار کند میشوند، میانگین میتواند مشکل را پنهان کند. زمان پاسخ انتهایی، صف ورودی و خطاهای برنامه را در کنار معیارهای دیسک ببینید. اگر کندی همزمان با پشتیبانگیری رخ میدهد، زمانبندی یا محدودیت منابع آن کار باید بررسی شود. اگر بدون پشتیبان نیز کندی وجود دارد، ابتدا مسیر دیسک، شبکه و فشار گره را جدا کنید. نسبت دادن هر تأخیر به تعداد replicaها بدون مشاهده، راهنمای قابل اعتمادی نیست.
سیاست حذف snapshot هم باید مالک داشته باشد. نگه داشتن بینهایت نقطه بازیابی، ظرفیت را مصرف میکند و حذف عجولانه همه آنها نیز تاریخچه مورد نیاز را از بین میبرد. بازه نگهداری را با نیاز کسبوکار و پشتیبان مستقل هماهنگ کنید. در یک بازبینی دورهای، چند نسخه قدیمی را واقعاً بازیابی کنید تا معلوم شود سیاست فقط فضای مصرفی را مدیریت نمیکند، بلکه نقاط بازیابی مفیدی باقی میگذارد. ارزش نسخه پشتیبان در روز بازیابی مشخص میشود، نه در تعداد رکوردهای موفق زمانبند.


