
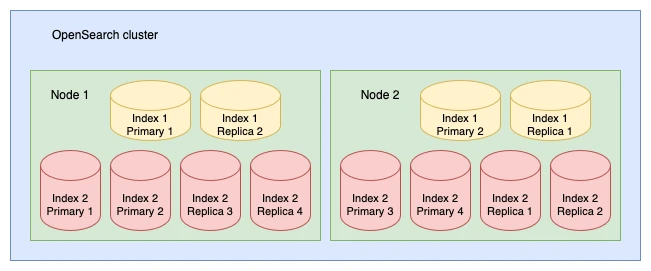
داده چگونه تقسیم میشود؟
در OpenSearch، سندها داخل Index قرار میگیرند و داده هر Index میان shardها توزیع میشود. هر shard اولیه میتواند replica داشته باشد. گرهها اجزای خوشه را اجرا میکنند و نقش مدیریت خوشه از نگهداری و جستوجوی داده قابل تفکیک است.
Replica برای دسترسپذیری و توزیع بخشی از بار خواندن اهمیت دارد، اما اگر روی همان گره اولیه قرار بگیرد هدف تحمل خرابی گره را برآورده نمیکند؛ تخصیص خوشه این محدودیت را لحاظ میکند. تعداد shard و replica بر هزینه منابع و رفتار بازیابی اثر میگذارد. افزودن آنها بدون شناخت اندازه و الگوی بار، الزاماً سرعت را بهتر نمیکند.
تمرین پیشنهادی برای فهم تخصیص
یک مجموعه کوچک از سندهای ساختگی با شناسه روشن وارد محیط آزمایشی کنید. پیش از هر تغییری، شمار سندها، محل تخصیص shardها و نتیجه چند جستوجوی ثابت را ثبت کنید. سپس تعداد گرهها یا replicaها را در یک مرحله تغییر دهید و نتیجه را مقایسه کنید.
اگر بخشی از تخصیص انجام نشده است، بهجای افزایش تصادفی ظرفیت، دلیل گزارششده را بخوانید. محدودیت دیسک، قواعد تخصیص و نبود گره مناسب، مسئلههای متفاوتی هستند. هدف تمرین، ارتباطدادن وضعیت خوشه با یک علت قابل توضیح است.
بار نوشتن و خواندن را جدا بسنجید
پیشنهاد تحریریه این است که یک بار ورود پیوسته سند و یک مجموعه پرسوجوی ثابت داشته باشید. زمان دریافت نوشتن، زمان دیدهشدن سند در جستوجو و زمان پاسخ را جدا ثبت کنید. نتیجه تنها یک پرسوجوی گرم، تصویر کامل رفتار عملیاتی نیست.
تعداد فیلدها، تغییر شکل داده و اندازه سندها را هم در گزارش نگه دارید. در مثال فرضی ثبت لاگ، افزودن ساختارهای نامنظم میتواند هزینهای بسازد که فقط با شمار رویدادها دیده نمیشود. مقایسه دو پیکربندی بدون ثابتبودن این شرایط ارزش محدودی دارد.
بازیابی مستقل لازم است
Replica را بهعنوان نسخه پشتیبان مستقل حساب نکنید. پیشنهاد ما بازیابی یک snapshot آزمایشی روی محیط جدا و مقایسه تعداد سندها و نتیجه پرسوجوهای مرجع است. صرف نمایش نام snapshot یا موفقیت ساخت Index، معیار کامل بازیابی نیست.
در نهایت، برای هر Index مالک، مدت نگهداری و قاعده حذف مشخص کنید. خوشهای که امروز پاسخ میدهد ولی برنامهای برای رشد و حذف داده ندارد، دیر یا زود با مسئله ظرفیت روبهرو میشود. این مقاله یک روش یادگیری و طراحی است، نه توصیه یک تعداد ثابت shard برای همه محیطها.
سند، نگاشت و معنای فیلد
در OpenSearch، داده را به صورت سند وارد میکنید، اما کیفیت جستوجو به معنای فیلدها وابسته است. نام کاربر، عدد مبلغ، زمان رخداد و متن توضیح نباید بدون فکر مانند یک نوع داده رفتار کنند. برای مثال، جستوجوی واژه در متن توضیح با تطبیق دقیق شناسه سفارش نیاز متفاوتی دارد. پیش از وارد کردن حجم زیاد، چند سند نماینده بنویسید و برای هر فیلد مشخص کنید آیا هدف جستوجوی متنی، فیلتر دقیق، مرتبسازی یا محاسبه آماری است. این تصمیم طراحی نگاشت را هدایت میکند.
نگاشت پویا برای شروع سریع مفید است، ولی در داده سازمانی ممکن است نوع ناخواستهای از نخستین نمونه استنباط شود. اگر یک مقدار در روز اول عدد و روز بعد رشته باشد، ورود داده میتواند با مشکل مواجه شود. برای فیلدهای مهم نگاشت صریح و قالب ورودی مشخص داشته باشید. داده نامعتبر را با شناسه و علت خطا در مسیر جداگانه نگه دارید تا بتوان آن را اصلاح کرد. حذف بیصدای سند ناموفق، آمار داشبورد را بدون هشدار ناقص میکند.
Shard واحد تقسیم داده است
شاخههای اصلی ایندکس داده را میان گرهها تقسیم میکنند و replicaها نسخههای دیگری برای تحمل خرابی و برخی بارهای خواندن فراهم میآورند. تعداد زیاد shard الزاماً عملکرد بهتر نمیسازد؛ هر shard هزینه مدیریتی و منابع خود را دارد. از طرف دیگر، تقسیم ناکافی میتواند انعطاف رشد را محدود کند. انتخاب باید بر اساس اندازه داده، الگوی پرسوجو و تعداد گرهها آزمایش شود. عددی که برای یک ایندکس لاگ مناسب بوده ممکن است برای کاتالوگ محصول مناسب نباشد.
در یک خوشه تکگرهای، انتظار نداشته باشید replica همان حفاظت جداسازیشده چندگرهای را فراهم کند. وضعیت تخصیص را ببینید و علت shardهای تخصیصنیافته را بررسی کنید. تغییر تعداد replica برای سبز کردن ظاهری وضعیت، بدون فهم علت، میتواند معنای تحمل خرابی را عوض کند. ابتدا مشخص کنید وضعیت فعلی چه ریسکی برای دسترسپذیری یا افزونگی دارد. سپس تصمیم را با ظرفیت و هدف محیط آزمایش یا تولید هماهنگ کنید.
تفاوت Replica و نسخه پشتیبان
Replica برای ادامه کار خوشه و توزیع برخی عملیات مفید است، اما اگر حذف منطقی اشتباه در ایندکس انجام شود، این تغییر میتواند در نسخههای دیگر نیز منعکس شود. بنابراین replica جای snapshot و طرح بازیابی را نمیگیرد. برای داده مهم، یک سند نشانه با مقدار معلوم ثبت کنید و پس از تهیه پشتیبان، بازیابی آن را در محیط جدا انجام دهید. نتیجه باید نشان دهد هم داده و هم قابلیت جستوجوی مورد نیاز برگشتهاند. وجود فایل پشتیبان به تنهایی کافی نیست.
در طرح بازیابی، نام ایندکسها، الگوهای قالب و تنظیمات مورد نیاز برنامه را لحاظ کنید. اگر برنامه از alias استفاده میکند، بازسازی داده بدون اتصال درست alias ممکن است باعث شود برنامه هنوز ایندکس خالی یا قدیمی را ببیند. زمان بازیابی را با حجم نماینده اندازه بگیرید و آن را به عنوان نتیجه همان آزمایش ثبت کنید. رشد داده و تغییر زیرساخت میتواند این زمان را تغییر دهد؛ آزمون قدیمی را برای همیشه معتبر فرض نکنید.
مسیر ورود داده و خطاهای جزئی
عملیات گروهی ورود داده میتواند همزمان نتایج موفق و ناموفق داشته باشد. برنامه تولیدکننده باید پاسخ هر بخش را بررسی کند و صرف دریافت یک پاسخ کلی را موفقیت همه اسناد نداند. برای تلاش مجدد، شناسه سند و نوع عملیات را طوری انتخاب کنید که تکرار ناخواسته اثر قابل پیشبینی داشته باشد. اگر هر بار شناسه تازه تولید شود، تکرار ارسال ممکن است سند تکراری بسازد. اگر یک شناسه ثابت بدون طراحی استفاده شود، ممکن است داده قبلی ناخواسته بازنویسی شود.
برای تمرین، دستهای کوچک شامل سند سالم، سند با نوع فیلد نادرست و سند تکراری بسازید. بررسی کنید هر کدام چه نتیجهای میگیرند و برنامه چگونه آن را گزارش میکند. سپس قطع کوتاه ارتباط را شبیهسازی کنید و رفتار تکرار ارسال را ببینید. این آزمایش نشان میدهد تضمین کیفیت داده تنها به خوشه مربوط نیست؛ تولیدکننده و مسیر جمعآوری نیز باید قرارداد روشن و قابل آزمون داشته باشند.
جستوجوی متنی با فیلتر دقیق فرق دارد
وقتی کاربر یک عبارت مینویسد، موتور ممکن است متن را تحلیل و به واحدهای قابل جستوجو تبدیل کند. در مقابل، یک فیلتر شناسه معمولاً به تطبیق دقیق نیاز دارد. اگر نتیجه مورد انتظار پیدا نمیشود، ابتدا نوع فیلد و روش جستوجو را بررسی کنید. تغییر بیهدف امتیازدهی زمانی که فیلد اصلاً برای هدف درست نگاشت نشده، مسئله را حل نمیکند. مجموعهای از پرسوجوهای نمونه با نتیجه مورد انتظار بسازید و پس از تغییر نگاشت یا تحلیلگر آنها را تکرار کنید.
برای زبان فارسی، کیفیت داده و یکسانسازی نویسهها میتواند در تجربه جستوجو مهم باشد. تفاوت شکل حروف، فاصله و نیمفاصله را در نمونههای آزمون بگنجانید. انتخاب تحلیلگر باید با مستندات و نیاز واقعی محصول بررسی شود؛ یک تنظیم کلی برای همه محتواها وجود ندارد. همچنین معیار را تنها تعداد نتیجه قرار ندهید. نتیجهای که زیاد برمیگرداند ولی موارد مرتبط در آن پیدا نمیشوند، از دید کاربر موفق نیست. نمونههای واقعی و داوری محتوایی در کنار معیار فنی لازماند.
عیبیابی کندی با سؤال مشخص
کندی نوشتن و کندی جستوجو ممکن است علت متفاوت داشته باشند. برای نوشتن، نرخ ورود، خطاهای دستهای، مصرف دیسک و صفهای پردازش را ببینید. برای جستوجو، شکل پرسوجو، بازه داده، تعداد نتایج و همزمانی را ثبت کنید. یک پرسوجوی نمونه را با همان ورودی تکرار کنید تا اثر تغییر قابل مقایسه باشد. افزایش منابع بدون فهم گلوگاه ممکن است هزینه را بالا ببرد و مسئله نگاشت یا پرسوجوی نامناسب را باقی بگذارد.
دیسک پر یا نزدیک به محدودیت میتواند رفتار خوشه را تغییر دهد. فقط فضای فایلسیستم را نگاه نکنید؛ وضعیت تخصیص و پیامهای خود خوشه نیز اهمیت دارند. حذف عجولانه فایلهای داده از مسیر داخلی روش مناسبی برای آزاد کردن فضا نیست و میتواند داده را خراب کند. مدیریت عمر ایندکس و حذف کنترلشده از رابطهای پشتیبانیشده باید از قبل طراحی شود. اگر نیاز به نگهداری طولانی دارید، هزینه و مسیر آرشیو را پیش از رسیدن به بحران ظرفیت مشخص کنید.
امنیت داده و دسترسی جستوجو
دسترسی خواندن ایندکس میتواند حجم بزرگی از اطلاعات را آشکار کند. نقشهای برنامه، تحلیلگر و مدیر خوشه را جدا کنید و نتیجه را با حساب محدود آزمایش کنید. همچنین نام ایندکس به تنهایی مرز قابل اعتماد نیست؛ قواعد واقعی مجوز تعیین میکنند چه چیزی قابل مشاهده است. داده حساس را تا حد امکان پیش از ورود کمینه کنید. اگر لاگ شامل توکن یا رمز باشد، رمزنگاری دیسک مشکل دسترسی کاربران مجاز به همان داده را حل نمیکند.
برای ابزارهای مدیریتی، مسیر شبکه و احراز هویت را روشن نگه دارید. نمونه آزمایشی با تنظیم ساده را بدون بازبینی به اینترنت یا شبکه گسترده منتقل نکنید. در محیط تیمی، تغییر نگاشت، حذف ایندکس و مدیریت snapshot باید قابل ردیابی باشد. هنگام بررسی حادثه، دانستن اینکه چه کسی و چه زمانی ساختار یا داده را تغییر داده به اندازه دیدن خطای پرسوجو اهمیت دارد. این شواهد را با سیاست نگهداری مناسب حفظ کنید.
طرح یک آزمایش تصمیمساز
یک مجموعه داده کوچک ولی نماینده از محتوای خودتان آماده کنید. چند جستوجوی پرتکرار، یک عملیات ورود گروهی و یک سناریوی بازیابی را اجرا کنید. سپس فقط یک متغیر مانند نگاشت فیلد یا اندازه دسته را تغییر دهید و نتیجه را مقایسه کنید. هدف پیدا کردن تنظیم جادویی نیست؛ هدف شناخت رابطه نیاز محصول و رفتار خوشه است. گزارش نهایی باید بگوید چه چیزی اندازهگیری شد، چه چیزی بهتر شد و کدام محدودیت هنوز باقی است. چنین گزارشی مبنای معتبرتری برای رشد خوشه از شمارش صرف گرهها فراهم میکند.


