
چرا این موضوع مهم است؟
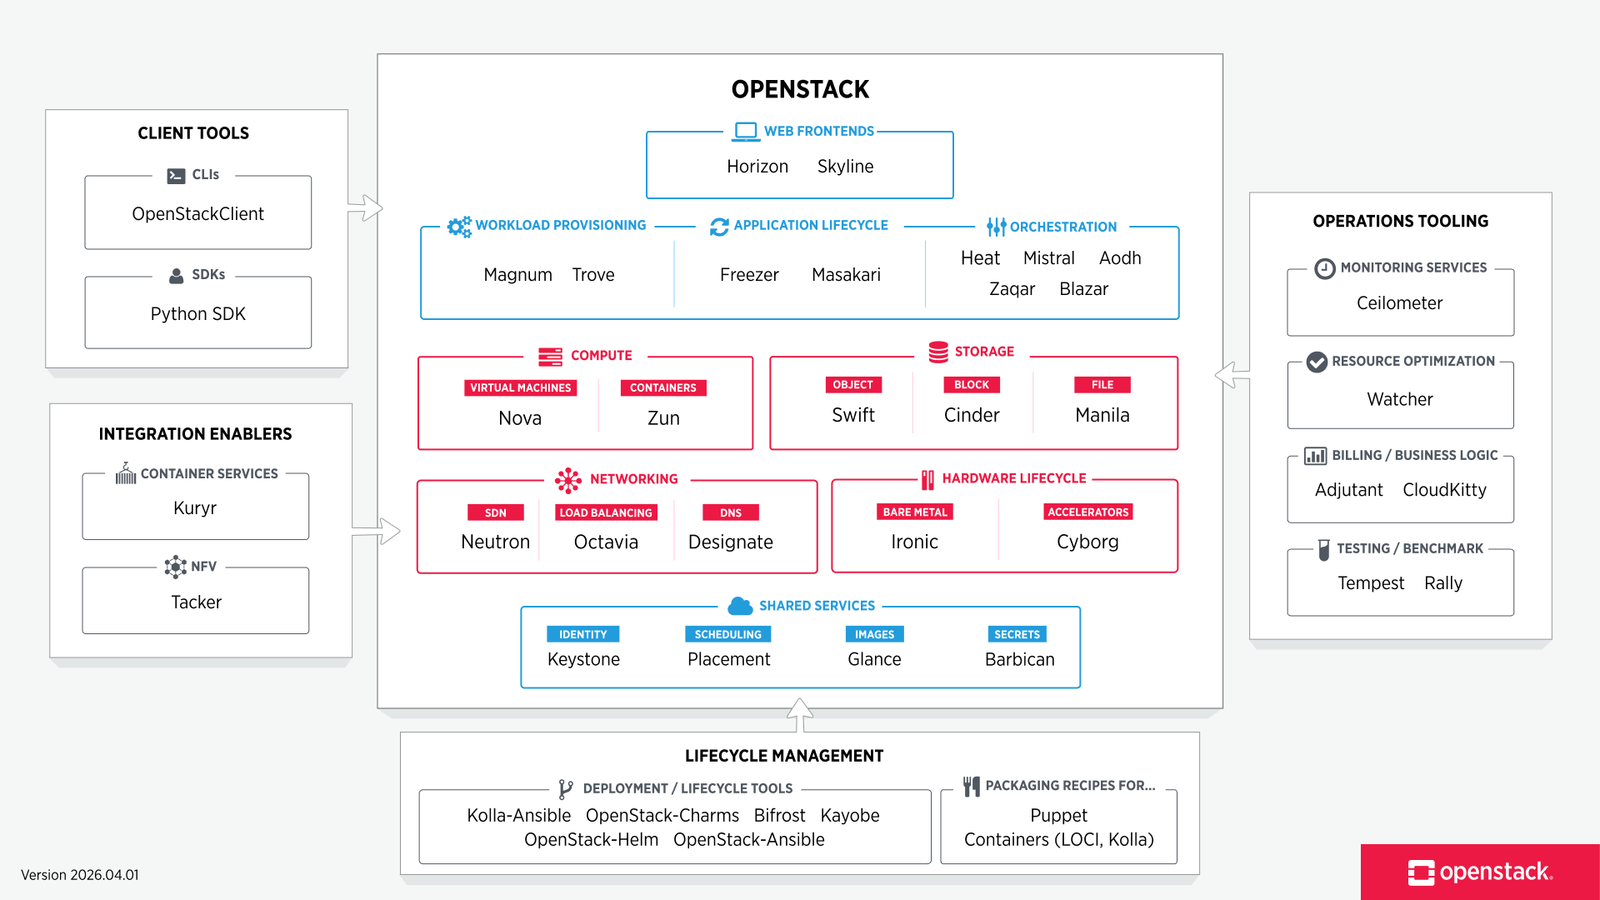
OpenStack یک برنامهٔ واحد نیست؛ مجموعهای از سرویسها با APIهای مستقل است. Keystone identity و token، Nova compute، Neutron network، Glance image و Cinder block storage را فراهم میکنند و message bus/database state را پشت صحنه هماهنگ میکند.
در یک سیستم واقعی، قبل از انتخاب ابزار باید مدل ذهنی درستی از لایهها داشته باشید. هر بار که یک مشکل را فقط با یک command یا تنظیم حفظی حل میکنیم، دانش به نسخه و محیط خاص گره میخورد. روش بهتر این است که ورودی، state، policy، مسیر داده و خروجی را مشخص کنیم. بعد ابزار را برای مشاهدهٔ یکی از این لایهها انتخاب کنیم. این رویکرد باعث میشود وقتی نسخه یا توزیع عوض شد، هنوز بدانیم دنبال چه evidenceای هستیم.
مدل معماری
در موضوع معماری سرویسمحور OpenStack و وابستگی بین اجزا، componentها را روی یک مسیر ساده بکشید و مرز مسئولیت هرکدام را مشخص کنید. state پایدار، state runtime، dependency بیرونی و نقطهٔ اعمال policy را جدا کنید. وقتی diagram ساده دارید، خطا از یک «سیستم بزرگ و مبهم» به چند مرحلهٔ قابل آزمون تبدیل میشود.
روش عملی کار
یک درخواست ساخت server را از CLI با request ID دنبال کنید. ابتدا token، سپس image/flavor/network و در نهایت scheduling و spawn را ببینید. این مدل باعث میشود خطا را به سرویس درست نسبت دهید.
برای Production، تغییر باید قابل اندازهگیری و قابل برگشت باشد. baseline قبل از تغییر شامل نسخه، config مؤثر، log سالم، metric اصلی و یک تست end-to-end است. rollout را با canary شروع کنید؛ بعد از هر مرحله هم تست مثبت و هم تست منفی داشته باشید. اگر success criterion از قبل نوشته نشده باشد، بعد از اجرا بهسادگی هر نتیجهای را میتوان «موفق» تفسیر کرد. rollback هم باید تمرین شود، نه اینکه فقط یک دستور روی کاغذ باشد.
از دید امنیت
هر خطای ساخت VM را Nova error ندانید. failure در quota، image، network port، volume یا identity ممکن است در تجربهٔ کاربر فقط به شکل build failed دیده شود.
از دید امنیت، کمکردن سطح دسترسی مهم است اما availability و قابلیت عیبیابی هم جزو امنیت عملیاتیاند. secretها، tokenها، capabilityها، network path و logهای حساس را جدا بررسی کنید. هر exception باید owner، دلیل و تاریخ بازبینی داشته باشد. کنترلهایی که هیچکس نمیتواند اثرشان را مشاهده یا علتشان را توضیح دهد، در زمان incident به مانع تبدیل میشوند.
آزمایشگاه پیشنهادی
یک VM با network و volume بسازید و همزمان logهای API/scheduler/conductor و Neutron را با request ID دنبال کنید. سپس یک failure کنترلشده مثل quota محدود ایجاد کنید.
برای هر مرحله timestamp و خروجی را ذخیره کنید. یک failure کنترلشده ایجاد کنید تا مطمئن شوید monitoring واقعاً failure را میبیند. سپس سیستم را به baseline برگردانید و زمان recovery را ثبت کنید.
عیبیابی بر پایهٔ Evidence
Troubleshooting را با تغییر config شروع نکنید. اول محل دقیق failure را پیدا کنید: آیا ورودی وارد سیستم میشود؟ آیا state مورد انتظار ساخته شده؟ آیا policy اجازه میدهد؟ آیا خروجی از component خارج میشود؟ log، packet capture، metric و state API باید به یک timeline مشترک وصل شوند. نبودن event نیز evidence است؛ اگر request قبل از یک component دیده میشود و بعد از آن نه، دامنهٔ مسئله کوچک شده است.
Performance و ظرفیت
عملکرد را فقط با average نسنجید. p95/p99 latency، saturation، queue depth، retry و resource pressure تصویر بهتری میدهند. تغییری که در lab کوچک سریع است ممکن است زیر concurrency یا dataset واقعی bottleneck متفاوتی نشان دهد. capacity limitها را قبل از rollout بزرگ شناسایی کنید و alert را به thresholdهای قابل اقدام وصل کنید.
Production readiness
قبل از rollout نهایی، owner، change window، blast radius، success metric و rollback trigger باید مشخص باشند. اگر dependency خارجی دارید، رفتار هنگام timeout یا unavailable شدن آن را تست کنید. اگر config به چند host میرود، rollout مرحلهای و inventory دقیق لازم است. یک تغییر خوب باید observable، explainable و reversible باشد.
Runbook و انتقال دانش
در مستندسازی، فقط «چه دستورهایی اجرا شد» را ننویسید. سؤال، فرضیه، evidence مورد انتظار، نتیجه و دلیل تصمیم را ثبت کنید. اگر همکار دیگری بتواند با همان ورودی آزمایش را تکرار کند و به نتیجهٔ مشابه برسد، runbook ارزش عملیاتی دارد. اگر فقط نویسنده میداند چرا مرحلهای لازم است، دانش هنوز منتقل نشده است.
قبل از Production چه چیزی را اعتبارسنجی کنیم؟
نتیجهٔ Lab را مستقیم به Production تعمیم ندهید. یک change plan کوتاه بسازید که در آن دامنهٔ تغییر، owner، زمان اجرا، dependencyها، success metric و rollback trigger مشخص باشد. ابتدا روی canary یا درصد کوچکی از workload اجرا کنید و حداقل یک چرخهٔ واقعی restart، credential rotation یا deploy دوم را ببینید؛ بسیاری از خطاها در اولین اجرای سالم ظاهر نمیشوند. رفتار هنگام unavailable شدن dependency خارجی، پر شدن disk، timeout شبکه و ورودی نامعتبر را نیز بررسی کنید. اگر feature امنیتی است، test منفی باید نشان دهد مسیر غیرمجاز واقعاً بسته است؛ اگر feature performance است، benchmark باید با load و dataset نزدیک به واقعیت اجرا شود. در پایان، تصمیم rollout را با evidence ثبت کنید، نه با جملهٔ مبهم «بهنظر خوب است».
نگهداری بلندمدت و بازبینی دورهای
معماری بعد از deploy ثابت نمیماند. نسخهٔ سیستمعامل، dependency، policy سازمان، certificate، endpoint و حجم workload تغییر میکنند. برای همین باید بازبینی دورهای تعریف شود: نسخههای پشتیبانینشده را پیدا کنید، exceptionهای قدیمی را ببندید، alertهای بیارزش را حذف کنید و recovery را دوباره تمرین کنید. اگر configuration در Git نگهداری میشود، drift میان state واقعی و repository را اندازه بگیرید. اگر ابزار SaaS یا سرویس خارجی است، تغییر API، pricing، limit و مدل permission را دنبال کنید. مستندات باید تاریخ review داشته باشند تا تیم بداند کدام فرضها هنوز معتبرند. نگهداری خوب یعنی سیستم بعد از شش ماه هم قابل توضیح و قابل بازیابی باشد، نه اینکه فقط روز اول deploy موفق بوده باشد.
جمعبندی
هدف این مقاله دربارهٔ معماری سرویسمحور OpenStack و وابستگی بین اجزا ارائهٔ یک دستور جادویی نیست؛ هدف ساختن مدل ذهنی است. وقتی معماری را بفهمید، baseline داشته باشید و تغییر را با evidence کوچک کنید، ابزارها قابل تعویض میشوند اما روش حل مسئله باقی میماند. منبع اصلی این مقاله از OpenStack انتخاب شده تا جزئیات فنی قابل پیگیری باشند.
چکلیست سریع
- مسئله را در یک جمله تعریف کن.
- component و مرز اعتماد را مشخص کن.
- baseline را قبل از تغییر ذخیره کن.
- یک test مثبت و یک test منفی بساز.
- تغییر را با canary شروع کن.
- evidence را timestampدار نگه دار.
- rollback را واقعاً تمرین کن.
- نتیجه و exceptionها را در runbook ثبت کن.
دنبال کردن یک درخواست ساخت ماشین
برای فهم ارتباط سرویسها، یک ماشین آزمایشی بدون داده حساس بسازید و شناسه درخواست را نگه دارید. کاربر ابتدا با محدوده مناسب پروژه احراز هویت میشود. تصویر انتخابی باید در Glance قابل دسترس باشد و نوع ماشین باید منابع مورد نیاز را توصیف کند. Nova هماهنگی ایجاد ماشین را انجام میدهد، اما شبکه را خود به تنهایی پیاده نمیکند؛ درگاه و اتصال شبکه به همکاری Neutron نیاز دارد. اگر دیسک ریشه از حجم ساخته شود، مسیر Cinder نیز وارد عملیات میشود. نمایش یک وضعیت نهایی در پنل، خلاصه چند عملیات مستقل است و نباید آن را معادل یک تراکنش ساده در یک برنامه دانست.
فرض کنید ماشین در وضعیت خطا باقی میماند. ابتدا رویدادها و خطای همان ماشین را ببینید، سپس بررسی کنید آیا منابع محاسباتی متناسب با درخواست موجود بودهاند. کمبود ظرفیت با خطای دسترسی به تصویر فرق دارد. اگر ماشین روشن است ولی شبکه ندارد، وضعیت درگاه، تخصیص آدرس و گروه امنیتی را جداگانه بررسی کنید. اگر حجم متصل نشده، سلامت مسیر ذخیرهسازی اهمیت پیدا میکند. حذف و ساخت مکرر ماشین بدون جمعآوری این شواهد ممکن است تنها خطای موقت را پنهان کند و منابع باقیمانده بسازد.
پروژه، سهمیه و مرز مدیریت
پروژه را یک ظرف مدیریتی برای منابع و دسترسیها در نظر بگیرید، نه تضمین خودکار جداسازی کامل همه لایهها. دسترسی شبکه، سیاست API و پیکربندی میزبان نیز باید با نیاز سازمان سازگار باشند. سهمیه تعداد یا اندازه منابعی را که پروژه میتواند درخواست کند محدود میکند؛ داشتن سهمیه آزاد تضمین نمیکند میزبان فیزیکی ظرفیت مناسب دارد. در یک تمرین، دو پروژه کوچک بسازید و مشاهده کنید کدام تصاویر یا شبکهها مشترک و کدام خصوصی هستند. برای هر منبع مشترک، دلیل و مالک آن را ثبت کنید.
تصویر پایه باید مانند یک محصول نگهداری شود. تاریخ ساخت، بستههای اصلی، روش ورود و فرایند بهروزرسانی آن مشخص باشد. تصویری که رمز ثابت یا کلید خصوصی در خود دارد میتواند همه ماشینهای ساختهشده از آن را درگیر کند. در مقابل، حجم داده عمر متفاوتی از ماشین محاسباتی دارد. پیش از حذف ماشین، وابستگی حجمها و سیاست حذف آنها را بررسی کنید. صرف اینکه دیسک در سیستم مهمان دیده میشود معلوم نمیکند حذف ماشین چه اثری بر داده خواهد داشت.
آزمایش بازیابی در ابر خصوصی
یک سرویس نمونه با داده ساختگی راه بیندازید و سه سناریو را مستقل آزمایش کنید: راهاندازی دوباره ماشین، قطع کوتاه ارتباط شبکه و بازیابی داده در ماشین تازه. هدف سناریوی سوم این است که وابستگی پنهان به ماشین قدیمی آشکار شود. آدرس، شناسه حجم، تنظیمات برنامه و اعتبارنامه اتصال باید در طرح بازیابی لحاظ شوند. snapshot جای پشتیبان مستقل و آزموده را نمیگیرد؛ حتی اگر ساخت snapshot موفق باشد، سازگاری داده برنامه و توان بازیابی آن همچنان باید بررسی شود.
برای تیم عملیات، یک نقشه ساده از کنترلکنندهها، میزبانهای محاسباتی، مسیر مدیریت و مسیر داده تهیه کنید. عبور ترافیک API با عبور بستههای مهمان یکسان نیست و سلامت یکی سلامت دیگری را ثابت نمیکند. در گزارش خرابی بنویسید کدام پروژه، ماشین و درگاه تحت تأثیر بودهاند. زمان دقیق رخداد و عملیات همزمان، مانند مهاجرت یا تغییر گروه امنیتی، معمولاً از فهرست طولانی نسخهها مفیدتر است. این روش امکان میدهد مسئله به تیم مسئول همان لایه سپرده شود و تغییرات بیهدف در کل ابر کاهش یابد.


