
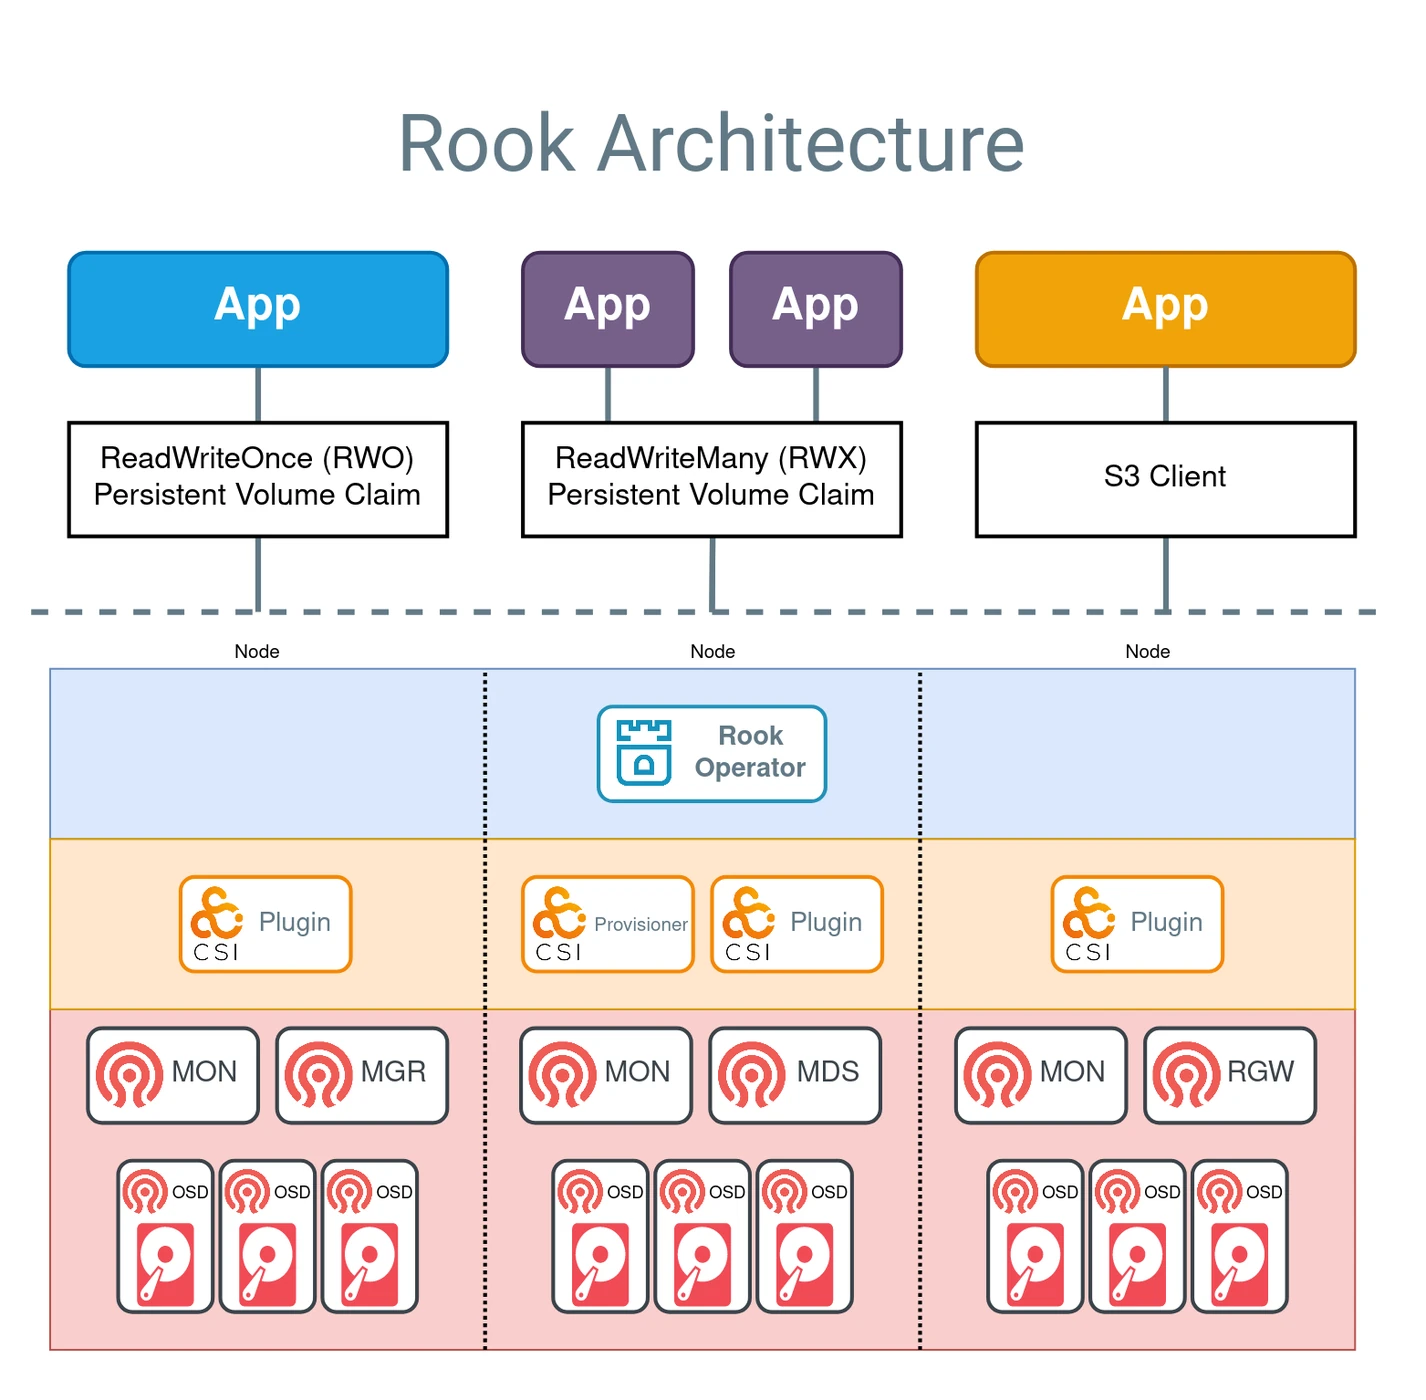
کنترلگر چه چیزی را اداره میکند؟
Rook الگوی Operator را برای اداره سامانه ذخیرهسازی در Kubernetes به کار میگیرد. در استقرار مبتنی بر Ceph، منابع اعلامی خوشه به مؤلفهها و تنظیمات موردنیاز ترجمه و وضعیت آنها دنبال میشود. خود Ceph مسئول بخش اصلی نگهداری و ارائه داده است؛ کنترلگر Rook مسیر عبور همه بایتهای برنامه نیست.
لایه CSI اتصال نیازهای ذخیرهسازی Kubernetes به سامانه پشتی را فراهم میکند. منابعی مانند PVC، تنظیم کلاس ذخیرهسازی و سلامت اجزای Ceph به یکدیگر مربوطاند، اما مشاهده موفقیت یک مرحله به معنی تضمین سلامت همه مراحل نیست. نمودار منبع، همین تفکیک نقشها را نشان میدهد.
تمرین پیشنهادی برای تیم زیرساخت
در یک محیط غیرعملیاتی، یک برنامه کوچک بسازید که دادهای قابل شناسایی روی حجم بنویسد. شناسه داده، نام حجم و محل منطقی منابع را ثبت کنید. سپس برنامه را جابهجا کنید و خواندن همان داده را بررسی کنید. موفقیت ایجاد PVC را با موفقیت بازیابی برنامه یکی نگیرید.
برای مرحله بعد، تنها یک خرابی کنترلشده را شبیهسازی کنید و زمان بازسازی را بسنجید. پیش از آزمایش، ظرفیت خالی و حد توقف را مشخص کنید تا تمرین به کمبود فضا و خرابی دوم منجر نشود. عددی که از این آزمایش به دست میآید به همان سختافزار و بار مربوط است.
مرز خرابی را با نقشه فیزیکی تطبیق دهید
پیشنهاد تحریریه این است که تعداد replica را کنار محل واقعی دیسک، میزبان، رک و منبع برق بررسی کنید. چند ماشین مجازی روی یک سرور فیزیکی، همه سناریوهای خرابی مستقل را پوشش نمیدهند. همچنین درباره باقیماندن ظرفیت پس از خروج یک میزبان تصمیم بگیرید؛ فقط وضعیت سالم امروز را اندازه نگیرید.
تکثیر و نسخه پشتیبان دو پاسخ متفاوتاند. حذف اشتباه داده یا اعمال تنظیم نامناسب ممکن است در همه نسخههای زنده بازتاب پیدا کند. برای یک برنامه فرضی حساس، بازیابی روی محیط جدا و خواندن داده معتبر باید بخشی از معیار پذیرش باشد.
مسئولیت عملیاتی روشن
تیم برنامه، تیم Kubernetes و تیم ذخیرهسازی باید بدانند در خطای اتصال یا کندی چه شواهدی را تحویل میدهند. پیشنهاد ما ثبت زمان رخداد، شناسه حجم، خطای برنامه و وضعیت بازسازی در یک پرونده واحد است. این کار از پاسدادن مسئله میان تیمها با جمله کلی «کلاستر سبز است» مفیدتر خواهد بود.
دو سامانه با دو مسئولیت متفاوت
Rook یک کنترلگر برای مدیریت چرخه عمر سامانه ذخیرهسازی در Kubernetes است. Ceph مسئول نگهداری و ارائه داده است. این تفکیک به ظاهر ساده، در حادثه تعیینکننده است: توقف operator الزاماً به معنی توقف فوری همه خواندن و نوشتنهای موجود نیست، ولی میتواند ساخت منابع تازه یا اصلاح وضعیت را مختل کند. برعکس، سالم بودن pod کنترلگر تضمین نمیکند دیسکها و مسیر داده سالم باشند. داشبورد باید هر دو سطح را جدا نشان دهد و خطا را به مسئولیت درست نسبت دهد.
در یک نمونه کاربردی، برنامه یک PersistentVolumeClaim درخواست میکند. کنترلپلین Kubernetes و درایور CSI در تهیه و اتصال volume نقش دارند. پس از آماده شدن مسیر، داده برنامه از اجزای مربوط به Ceph عبور میکند. اگر claim در حالت انتظار مانده باشد، رخدادهای provisioning اهمیت دارند؛ اگر volume متصل است ولی نوشتن کند شده، بررسی تنها لاگ operator کافی نیست. این دو مسئله حتی اگر از دید کاربر هر دو «مشکل دیسک» باشند، مسیر تشخیص متفاوت دارند.
اجزای Ceph و نقش آنها
Monitorها اطلاعات حیاتی خوشه و توافق مربوط به نقشهها را نگه میدارند. OSDها به داده و دیسکها مربوطاند. Manager برای وظایف مدیریتی و قابلیتهای پایش نقش دارد. در فایلسیستم مشترک، MDS به metadata فایلسیستم مربوط میشود و در ذخیره شیء، gateway رابط کاربردی ارائه میکند. تعداد podها را با تعداد نسخههای داده اشتباه نگیرید. وجود چند جزء مدیریتی به تنهایی نمیگوید یک شیء داده در چند دامنه خرابی نگهداری شده است.
وقتی یک دیسک یا میزبان از دست میرود، مکان داده و سیاست توزیع تعیین میکنند چه مقدار تحمل خرابی باقی مانده است. داشتن چند OSD روی یک میزبان، حفاظت در برابر از دست رفتن همان میزبان را مانند توزیع روی چند میزبان ایجاد نمیکند. دامنه خرابی باید با واقعیت برق، شبکه و محل استقرار سازگار باشد. اگر همه گرهها یک سوئیچ یا ذخیرهساز مشترک دارند، باید آن وابستگی نیز در تحلیل دیده شود. برچسبهای توپولوژی جای بررسی فیزیکی را نمیگیرند.
انتخاب میان block، filesystem و object
RBD معمولاً یک دستگاه بلوکی را برای مصرفکننده فراهم میکند و برنامه یا سیستمعامل روی آن فایلسیستم یا داده خود را مدیریت میکند. CephFS برای دسترسی فایلسیستمی مشترک طراحی شده و سازوکار metadata مخصوص دارد. Object gateway رابط ذخیره شیء میدهد و رفتار آن را نباید با یک پوشه POSIX یکسان فرض کرد. انتخاب باید از نیاز برنامه بیاید: قفل فایل، دسترسی همزمان، ترتیب نوشتن و API مورد استفاده چه هستند؟ تغییر نوع ذخیرهسازی فقط تغییر نام StorageClass نیست.
برای پایگاه داده، مدل دسترسی و سازگاری برنامه اهمیت زیادی دارد. چند replica برنامه را به یک volume بلوکی با فرض اشتراک امن متصل نکنید مگر طراحی برنامه و حالت دسترسی آن را پشتیبانی کند. در مقابل، استفاده از فایلسیستم مشترک هم همه مشکلات همزمانی برنامه را حل نمیکند. در آزمایش، دو نویسنده و رفتار قفل و بازیابی پس از قطع را بررسی کنید. داده آزمایشی باید امکان تشخیص نوشتن ناقص یا ناسازگار را داشته باشد، نه صرفاً یک فایل خالی.
ظرفیت قابل استفاده با ظرفیت خام فرق دارد
فضای خام دیسکها مستقیماً برابر فضای قابل تحویل به برنامه نیست. نسخهبرداری، کدگذاری، metadata و حاشیه لازم برای بازیابی از ظرفیت میکاهند. وقتی خوشه نزدیک پر شدن است، اضافه کردن داده یا جابهجایی پس از خرابی ممکن است محدود شود. آستانههای فضای آزاد باید پیش از نقطه اضطرار هشدار دهند. همچنین یک دیسک نامتوازن ممکن است زودتر از میانگین کل خوشه پر شود؛ نگاه کردن فقط به درصد مصرف مجموع میتواند این مشکل را پنهان کند.
بازسازی داده پس از خرابی منابع شبکه، دیسک و پردازنده مصرف میکند و با بار برنامه رقابت دارد. آزمایش عملکرد فقط در وضعیت کاملاً سالم کافی نیست. یک سناریوی کنترلشده از خروج یک جزء در محیط آزمایش انجام دهید و تأخیر برنامه در زمان بازیابی را بسنجید. تنظیم سرعت بازیابی یک مبادله دارد: سرعت بیشتر میتواند فشار روی برنامه را افزایش دهد و سرعت کمتر مدت کاهش افزونگی را طولانی کند. عدد مناسب به نیاز سرویس و ظرفیت واقعی وابسته است.
دیسک را قبل از واگذاری درست شناسایی کنید
هنگام انتخاب دستگاهها، نام موقتی دیسک را تنها شناسه قابل اعتماد فرض نکنید. موجودی دستگاه، شناسه پایدار، اندازه و کاربرد فعلی آن را بررسی کنید. واگذاری اشتباه دیسک دارای داده به فرایند آمادهسازی میتواند مخرب باشد. در محیط مجازی، دیسک ظاهراً جدا ممکن است روی همان ذخیرهساز زیرین قرار داشته باشد. هدف از بررسی، هم جلوگیری از پاک شدن داده و هم فهم دامنه خرابی است. این مرحله باید پیش از اعمال تنظیمات خودکار انجام شود.
اگر از PVC برای پشتوانه OSD استفاده میکنید، وابستگی به StorageClass زیرین را نیز تحلیل کنید. قرار دادن یک سامانه ذخیرهسازی روی سامانهای دیگر میتواند از نظر عملی معتبر باشد، ولی پیچیدگی و نقاط شکست تازهای میسازد. باید بدانید خرابی لایه زیرین چگونه به Ceph منتقل میشود و چه کسی مسئول بازیابی هر لایه است. ادعای افزونگی نباید فقط از تعداد podهای لایه بالا نتیجه گرفته شود.
عیبیابی claim و مسیر داده
برای claim منتظر، رخدادهای Kubernetes، نام StorageClass، پارامترهای pool، اعتبارنامه CSI و سلامت provisioner را بررسی کنید. برای خطای اتصال روی یک گره خاص، لاگ node plugin، قابلیتهای kernel و دسترسی شبکه آن گره اهمیت دارند. برای کندی سراسری، وضعیت Ceph، دیسکهای پر، تأخیر OSD و ترافیک بازیابی را ببینید. هر سؤال باید شاهد مربوط به خودش داشته باشد. راهاندازی مجدد همه podها ممکن است شواهد اولیه را از بین ببرد و فشار بیشتری بسازد.
اگر برنامه خطای ورودیوخروجی میبیند، زمان دقیق و عملیات درگیر را ثبت کنید. خطای خواندن، توقف نوشتن و تأخیر بالا یکسان نیستند. وضعیت سلامت Ceph را با رخداد برنامه و شبکه روی همان خط زمانی قرار دهید. یک هشدار ممکن است پیامد باشد، نه علت؛ مثلاً افزایش صف برنامه پس از کند شدن ذخیرهسازی رخ دهد. پیدا کردن نخستین تغییر قابل مشاهده به محدود کردن دامنه کمک میکند.
حذف، snapshot و پشتیبان
سیاست reclaim تعیین میکند پس از حذف claim چه بر سر volume میآید؛ آن را پیش از استفاده برای داده مهم بررسی کنید. حذف منابع مدیریتی یا namespace را به عنوان روش پاکسازی آزمایشی روی خوشه واقعی انجام ندهید. snapshot نیز لزوماً پشتیبان مستقل از خوشه نیست. اگر همه نسخهها روی همان Ceph باشند، خرابی گسترده یا حذف مدیریتی میتواند همه را درگیر کند. برای داده مهم، نسخهای با دامنه دسترسی و خرابی مستقل لازم است.
پشتیبان برنامه باید سازگاری کاربردی را نیز در نظر بگیرد. snapshot بلوک در لحظه نوشتن ممکن است فقط وضعیت crash-consistent بدهد و برای بازیابی پایگاه داده نیاز به سازوکار خود آن برنامه باشد. تمرین restore را در namespace یا محیط جدا انجام دهید و صحت داده را با پرسش واقعی برنامه بسنجید. موفقیت mount شدن volume به تنهایی نشان نمیدهد تراکنشها یا فایلها کاملاند. نتیجه بازیابی باید از دید مصرفکننده پذیرفته شود.
ارتقا و پذیرش معماری
سازگاری نسخه Rook، Ceph، CSI و Kubernetes را از مسیر ارتقای رسمی بررسی کنید. ارتقای همه لایهها در یک مرحله، نسبت دادن خطا به علت را سخت میکند. قبل از ارتقا، سلامت خوشه و نبود بازیابی سنگین را بررسی و ظرفیت برگشت یا توقف مرحله را مشخص کنید. در پایان، ساخت volume تازه، اتصال مجدد volume موجود و خواندن و نوشتن داده را آزمایش کنید. این سه آزمون بخشهای متفاوت معماری را میسنجند و تصویری دقیقتر از صرف آماده بودن podها میدهند.
برای پایش روزمره، رشد مصرف و مدت باقی ماندن وضعیت کاهش افزونگی را کنار خطای برنامه ببینید. هشدار سلامت باید به اقدام مشخص وصل شود: اضافه کردن ظرفیت، بررسی دیسک، اصلاح شبکه یا توقف تغییرات دیگر. نام یک هشدار به تنهایی راهنمای تعمیر نیست. ثبت تصمیم و شواهد همان رخداد کمک میکند تنظیمات بعدی بر تجربه واقعی خوشه متکی باشد.


