
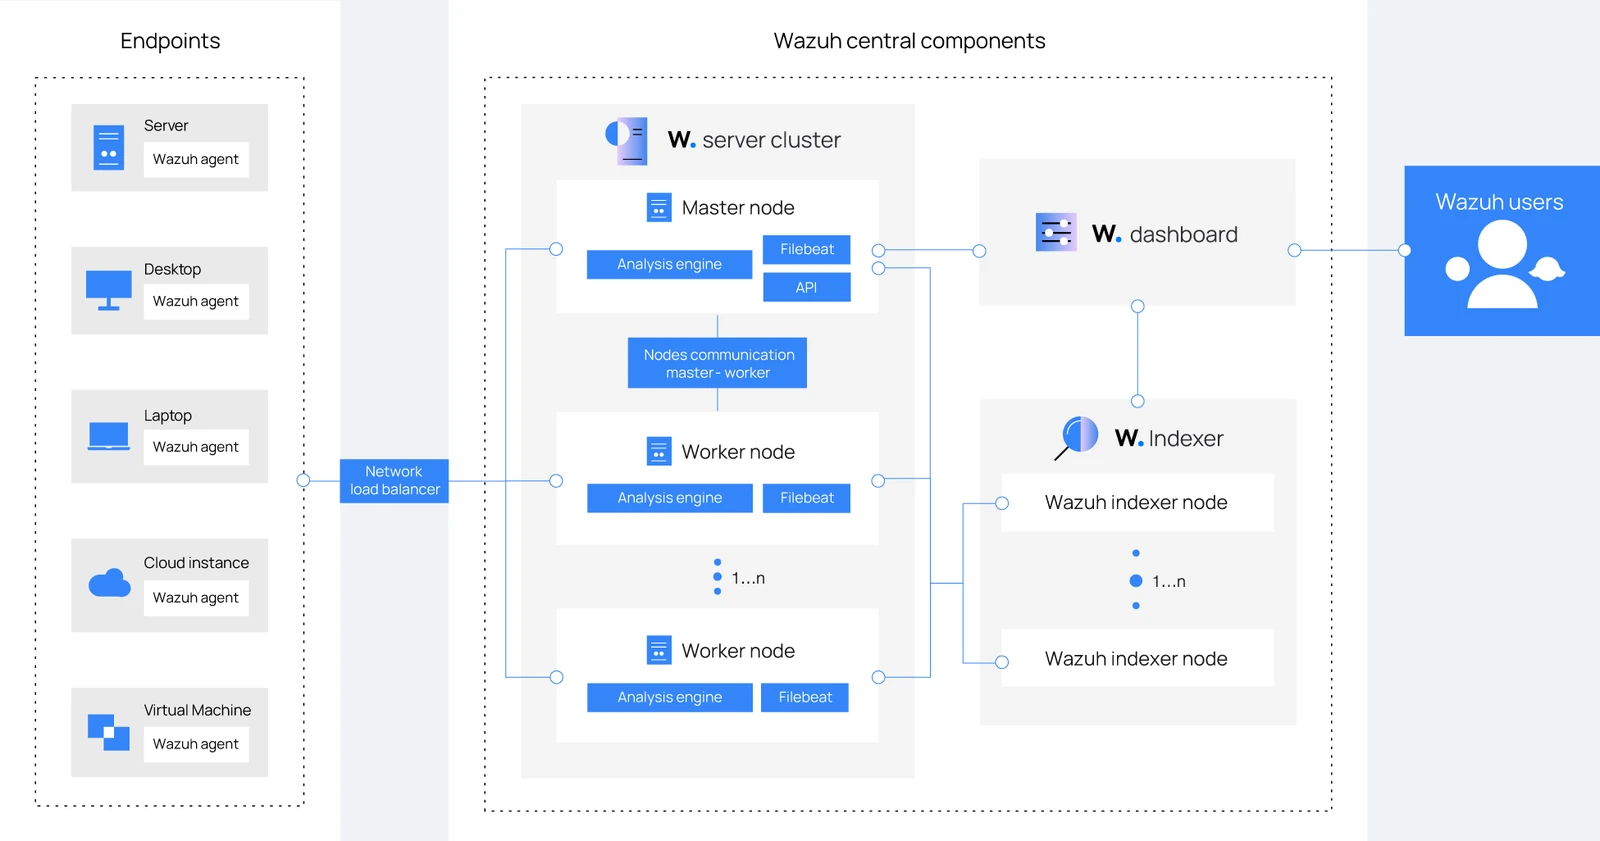
چهار نقش در یک مسیر
در معماری رسمی Wazuh، عامل روی میزبان داده امنیتی را جمع میکند و به سرور میفرستد. سرور رویداد را تحلیل میکند؛ Indexer داده را برای ذخیره و جستوجو آماده میسازد و Dashboard رابط مشاهده و بررسی آن است. سبزبودن یکی از این بخشها، سلامت همه مسیر را ثابت نمیکند.
استقرار همه مؤلفهها روی یک ماشین برای آزمایش سادهتر است. جداسازی سرویسها و استفاده از چند گره برای محیطهای بزرگتر، ظرفیت و تحمل خرابی را تغییر میدهد؛ بااینحال تعداد ماشین بهتنهایی معیار دسترسپذیری نیست. در مسیر سرور به Indexer، Filebeat و ارتباط رمزشده نقش دارند. سامانههای فاقد عامل نیز میتوانند با روشهای مناسب، داده لازم را در اختیار سامانه قرار دهند.
تمرین پیشنهادی: یک رویداد را گم نکنیم
در آزمایشگاهی جدا، یک ورود ناموفق ساختگی با زمان مشخص ایجاد کنید. ابتدا وجود آن را در لاگ میزبان ببینید؛ سپس دریافت در سرور، نتیجه تحلیل و نهایتاً قابل جستوجوبودن در داشبورد را بررسی کنید. ساعت میزبان و اجزای مرکزی را مقایسه کنید تا تفاوت زمان با گمشدن رویداد اشتباه نشود.
حالا فرض کنید داشبورد هیچ هشداری نشان نمیدهد. بهجای عوضکردن همزمان چند تنظیم، مسیر را به چند سؤال تبدیل کنید: رویداد تولید شده است؟ عامل آن را خوانده؟ ارسال موفق بوده؟ قانون موردنظر فعال است؟ داده در بازه زمانی درست جستوجو میشود؟ برای هر پاسخ، یک شاهد ثبت کنید.
ظرفیت را با بار خودتان بسنجید
پیشنهاد تحریریه، ساخت یک نمونه بار با الگوی واقعی سازمان است: تعداد دستگاه، حجم رویداد، مدت نگهداری و پرسوجوهای معمول. فقط تعداد عاملها را مبنای خرید قرار ندهید. در یک سناریوی فرضی، چند میزبان پررویداد میتوانند فشار بیشتری از تعداد زیادی دستگاه کمکار ایجاد کنند.
همچنین زمان بازگشت پس از قطعی Indexer یا ارتباط شبکه را اندازه بگیرید. معیار پذیرش بهتر است شامل تأخیر رسیدن رویداد، عقبماندگی صف و قابلیت بازسازی زنجیره اتفاقها باشد. نتیجه آزمایش روی یک رویداد نمونه را به تضمین کشف همه تهدیدها تعمیم ندهید.
مدیریت دسترسی و داده
برای بهرهبرداری سازمانی، نقش مشاهدهگر را از نقش تغییر پیکربندی جدا تعریف کنید و درباره اطلاعات حساسی که وارد لاگ میشوند تصمیم بگیرید. پیشنهاد ما ثبت مالک هر منبع لاگ و مدت نگهداری آن است. یک داشبورد پر از داده، بدون مسئول رسیدگی و مسیر پاسخ، جای فرایند عملیاتی امنیت را نمیگیرد.
مرز جمعآوری، تحلیل و نمایش
عامل ممکن است به سرور متصل باشد، اما این اتصال به تنهایی ثابت نمیکند فایل مورد نظر خوانده میشود. سرور نیز ممکن است رویداد را دریافت کند ولی قاعدهای که انتظار دارید بر آن منطبق نشود. در نهایت داده میتواند در Indexer موجود باشد ولی فیلتر داشبورد آن را نشان ندهد. برای هر مرحله یک شاهد مستقل لازم است. در آزمایش آموزشی، یک پیام ساختگی با عبارت یکتا تولید کنید تا جستوجوی آن با رویدادهای واقعی اشتباه نشود و بتوانید مسیرش را بدون انتشار اطلاعات حساس دنبال کنید.
این تفکیک در تقسیم مسئولیت تیمها نیز کاربرد دارد. تیم میزبان مسئول تولید و دسترسی به لاگ است، تیم سامانه امنیتی تنظیم دریافت و تحلیل را نگه میدارد و تیم ذخیرهسازی ظرفیت و سلامت ایندکس را بررسی میکند. در سازمان کوچک ممکن است همه این نقشها یک نفر باشند، اما تفکیک منطقی همچنان مفید است. گزارش خطا باید بگوید آخرین مرحلهای که رویداد در آن دیده شد کجاست، نه اینکه تنها «داشبورد خراب است» را تکرار کند.
قرارداد لاگ و مسئله تغییر قالب
بسیاری از قواعد تحلیل به ساختار ورودی وابستهاند. تغییر نسخه برنامه یا قالب لاگ میتواند باعث شود فیلد کاربر، آدرس یا نتیجه عملیات دیگر به شکل قبلی استخراج نشود. پیش از ارتقای یک برنامه مهم، چند نمونه لاگ جدید را در محیط آزمایش بررسی کنید. یک پیام ظاهراً مشابه ممکن است از نظر فاصله، نام فیلد یا زمان با نسخه قبلی فرق داشته باشد. آزمون باید استخراج فیلد و نتیجه قاعده را هر دو بسنجد، زیرا وجود متن خام به تنهایی سلامت تحلیل را ثابت نمیکند.
برای نمونه، رخداد ورود ناموفق باید از ورود موفق و خطای داخلی سرویس تفکیک شود. اگر همه اینها به یک هشدار کلی تبدیل شوند، تحلیلگر زمینه کافی ندارد. در طراحی قاعده، نمونه مثبت و نمونهای نزدیک ولی بیخطر داشته باشید. نمونه نزدیک کمک میکند حساسیت بیشازحد آشکار شود. همچنین هنگام اصلاح decoder یا rule، قواعد قبلی را با همان دادههای ساختگی دوباره بررسی کنید تا حل یک قالب تازه، رفتار مورد انتظار قالب قدیمی را نشکند.
ساعت، زمان رخداد و تأخیر انتقال
زمان ثبتشده در لاگ، زمان دریافت و زمان قابل جستوجو شدن ممکن است متفاوت باشند. برای یک میزبان که مدتی قطع بوده، رویداد قدیمی میتواند بعداً برسد. اگر داشبورد فقط بازه چند دقیقه اخیر را نشان دهد، تحلیلگر ممکن است تصور کند داده گم شده است. در آزمایش، یک رویداد با زمان معلوم تولید کنید و هر سه زمان را تا حد امکان ثبت کنید. تفاوت را به عنوان تأخیر انتقال یا پردازش تحلیل کنید و وضعیت ساعت میزبان را نیز بررسی کنید.
یکسان بودن منطقه زمانی در ظاهر نمایش کافی نیست؛ ساعت واقعی اجزا باید هماهنگ باشد. اختلاف زمان میتواند ترتیب رخدادها را در بررسی حادثه مخدوش کند. برای خطاهای زمان، تغییر دستی همه ساعتها در محیط تولید اقدام مناسبی نیست. ابتدا منبع زمان و وضعیت همگامسازی را بررسی کنید و اصلاح را طبق رویه سیستمعامل انجام دهید. سپس یک رویداد تازه بسازید تا مطمئن شوید مسئله حل شده است. رویدادهای قدیمی ممکن است همچنان زمان ثبتشده قبلی را داشته باشند.
ظرفیت بر اساس رویداد و پرسوجو
دو سازمان با تعداد میزبان برابر میتوانند بار بسیار متفاوتی داشته باشند. یک سرور پایگاه داده پرکار یا سامانه با ثبت جزئیات زیاد ممکن است چندین برابر یک رایانه کماستفاده رویداد بسازد. برای برآورد اولیه، نرخ رویداد، اندازه تقریبی داده، مدت نگهداری و الگوی جستوجوی تحلیلگران را اندازه بگیرید. سپس رشد مورد انتظار و دورههای اوج را لحاظ کنید. خرید صرفاً بر اساس شمار عاملها ممکن است گلوگاه ذخیرهسازی یا پردازش را پنهان کند.
ظرفیت دریافت و ظرفیت جستوجو را جدا بسنجید. سامانهای ممکن است ورودی را بپذیرد ولی پرسوجوی گسترده چند تحلیلگر همزمان کند شود. در آزمایش بار، هم تولید رویداد و هم پرسوجوی نماینده داشته باشید. جستوجویی که کل تاریخ را بدون فیلتر میخواند با بررسی یک میزبان در یک ساعت هزینه یکسان ندارد. آموزش تحلیلگر برای محدود کردن بازه و استفاده از فیلد مناسب، بخشی از بهرهبرداری مؤثر است؛ البته نباید ضعف ظرفیت را با ممنوع کردن همه پرسوجوهای مفید پنهان کرد.
نگهداری داده و بازیابی
مدت نگهداری باید با هدف بررسی حادثه و نیاز سازمان هماهنگ باشد. نگهداری طولانی همه دادهها بدون طبقهبندی میتواند هزینه و ریسک افشای اطلاعات را افزایش دهد. از سوی دیگر حذف زودهنگام، بررسی رخدادی را که دیر کشف شده دشوار میکند. برای هر گروه داده مشخص کنید چه مدت در دسترس جستوجوی سریع میماند و چه چیزی در نسخه پشتیبان یا آرشیو قرار میگیرد. این تصمیم باید به زبان قابل فهم برای تیم پاسخگویی به حادثه نوشته شود.
نسخه پشتیبان فقط داده ایندکس نیست. تنظیمات قواعد، گروهبندی عاملها، گواهیها و اطلاعات لازم برای بازسازی سرویس نیز اهمیت دارند. اسرار را در محل مناسب نگه دارید و دسترسی به پشتیبان را محدود کنید. یک بازیابی آزمایشی در محیط جدا انجام دهید و نشان دهید رویداد مشخص قابل جستوجو است و قواعد سفارشی نیز برگشتهاند. موفق بودن فرایند کپی فایل، به تنهایی شاهد قابل استفاده بودن سامانه پس از خرابی نیست.
اعتماد به عامل و حفاظت از مسیر مدیریت
ثبت یک عامل تازه باید از مسیر کنترلشده انجام شود تا دستگاه ناشناس نتواند خود را به عنوان میزبان معتبر معرفی کند. موجودی عاملها را با داراییهای سازمان مقایسه کنید و موارد قدیمی یا تکراری را بررسی کنید. نام میزبان ممکن است تغییر کند یا در چند محیط تکرار شود، بنابراین برای پیگیری از شناسههای مناسب استفاده کنید. حذف عامل از فهرست مدیریتی را نیز با فرایند خروج دارایی هماهنگ کنید تا داده تاریخی مورد نیاز بیدلیل از دست نرود.
دسترسی به داشبورد و API مدیریتی باید متناسب با وظیفه باشد. تحلیلگری که هشدارها را بررسی میکند الزاماً نیاز به تغییر قواعد یا مدیریت عامل ندارد. همچنین لاگها ممکن است شامل نام کاربر، مسیر فایل و اطلاعات سازمانی باشند. نقشها را با داده واقعی مورد نیاز طراحی کنید و نتیجه را با حساب آزمایشی بسنجید. ورود موفق حساب محدود کافی نیست؛ باید بررسی شود که داده یا عملیات خارج از دامنه را واقعاً نمیتواند ببیند یا اجرا کند.
از هشدار تا تصمیم انسانی
هشدار یک سرنخ است و همیشه نتیجه نهایی حادثه نیست. قاعده ممکن است رفتار غیرمعمول را گزارش کند که در یک تغییر مجاز رخ داده است. تحلیلگر باید زمان، میزبان، کاربر و تغییرات همزمان را بررسی کند. اگر پاسخ خودکار تعریف میشود، ابتدا در حالت مشاهده و دامنه کوچک رفتار آن را بسنجید. یک واکنش اشتباه مانند قطع دسترسی حساب حیاتی میتواند به اختلال تبدیل شود. معیار فعال شدن و مسیر رفع اثر باید روشن باشند.
برای هر هشدار پرتکرار، مشخص کنید چه تصمیمی از تحلیلگر انتظار میرود. اگر هیچ اقدام یا بررسی مشخصی ندارد، شاید باید غنیسازی یا تنظیم شود. کاهش نویز با خاموش کردن بیبررسی همه هشدارهای یک دسته تفاوت دارد. نمونههای مثبت واقعی و موارد بیخطر را کنار هم مرور کنید و تغییر قاعده را با هر دو بسنجید. خروجی مطلوب سامانه تعداد زیاد هشدار نیست؛ توانایی یافتن رخداد مهم، توضیح شواهد و پیگیری اقدام است.
تمرین نهایی معماری
یک میزبان آزمایشی، یک نوع لاگ و یک قاعده مشخص انتخاب کنید. رخداد سالم و رخداد مورد انتظار برای هشدار را تولید کنید. سپس به ترتیب دریافت، تحلیل، ذخیره و نمایش را ثبت کنید. در مرحله بعد فقط یکی از اجزای غیرحیاتی آزمایش را موقتاً متوقف کنید و ببینید کدام نشانه سلامت تغییر میکند. پس از بازگشت، رسیدن دادههای عقبمانده را بررسی کنید. این تمرین به تیم یاد میدهد هر رنگ سبز در رابط دقیقاً چه چیزی را ثابت میکند و چه چیزی هنوز باید جداگانه آزموده شود.


