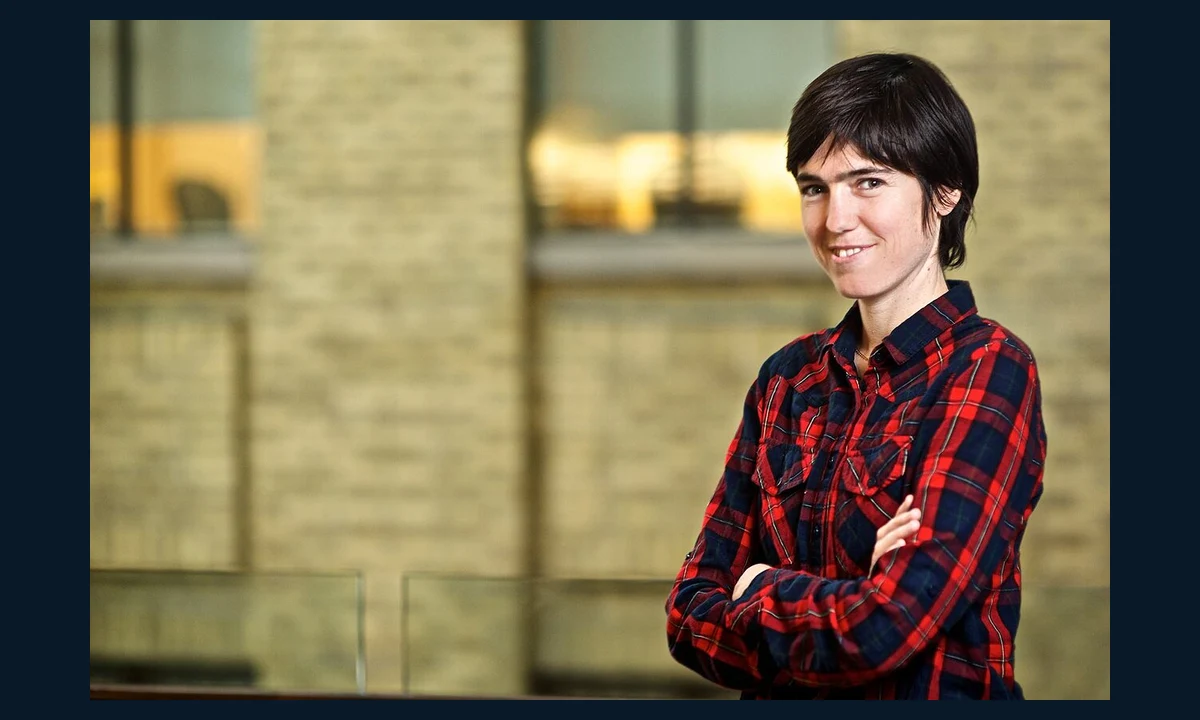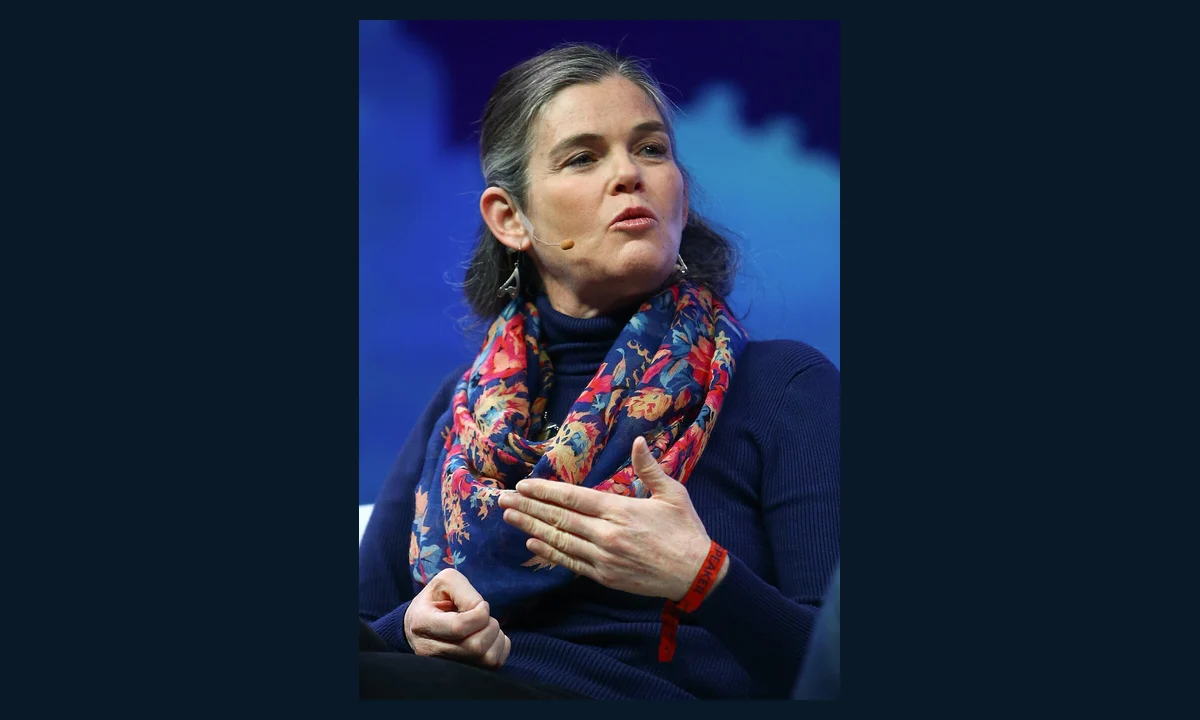
دافنه کولر استاد سابق استنفورد و پژوهشگر یادگیری ماشین است که در حوزه مدلهای گرافیکی احتمالاتی آثار مهمی دارد. او از همبنیانگذاران Coursera و بنیانگذار Insitro بوده است. فعالیتهای او نشان میدهد پژوهش دادهمحور از آموزش آنلاین تا زیستفناوری استفادههای متفاوت دارد، اما کشف دارو و توسعه درمان از نظر زمان و اعتبارسنجی با ساخت یک محصول نرمافزاری یکسان نیست. این متن با استناد به منبع اصلی و با هدف توضیح فنی موضوع برای مخاطب فارسیزبان تهیه شده است. در بازنویسی از گزارش کوتاه یا مشخصات تبلیغاتی فراتر میرویم تا پیشنیازها، محدودیتها و مثال عملی روشن شوند. با این حال هر ادعای تازه باید به داده قابل اتکا تکیه داشته باشد و هیچ نتیجه آزمایشگاهی یا حقوقی که مستند نیست به شکل خبر قطعی ارائه نمیشود.
اهمیت تاریخی این فعالیت
در تاریخ هوش مصنوعی، توسعه یک فناوری حاصل تعامل ایدههای علمی و امکانات مهندسی است. Daphne Koller در این روایت نقش قابل توجهی دارد، اما سهم دیگر پژوهشگران و شرایط نهادی نیز باید دیده شود. روش معتبر آن است که مسیر انتشار مقالهها، همکاریها و مسئولیتهای ثبتشده در وبسایتهای رسمی بررسی شود. به این ترتیب زندگینامه صرفاً فهرستی از سمتها نخواهد بود و میتواند به فهم دگرگونیهای فنی و اجتماعی صنعت کمک کند.
مسیر پژوهشی و حرفهای
دافنه کولر استاد سابق استنفورد و پژوهشگر یادگیری ماشین است که در حوزه مدلهای گرافیکی احتمالاتی آثار مهمی دارد. او از همبنیانگذاران Coursera و بنیانگذار Insitro بوده است. فعالیتهای او نشان میدهد پژوهش دادهمحور از آموزش آنلاین تا زیستفناوری استفادههای متفاوت دارد، اما کشف دارو و توسعه درمان از نظر زمان و اعتبارسنجی با ساخت یک محصول نرمافزاری یکسان نیست. برای فهم جایگاه Daphne Koller بهتر است به مسئلههایی که در طول فعالیت حرفهای مطرح کرده توجه کنیم، نه فقط عنوان سازمانها. ارزش یک مسیر علمی در پیوند میان دانش پایه، مشارکت گروهی و نتایجی است که دیگران توانستهاند بر آن بنا کنند. انتساب دستاوردی به یک نفر بدون در نظر گرفتن همکاران، زمان انتشار مقاله و محدودیتهای پروژه میتواند تاریخ فناوری را سادهسازی کند. بنابراین این زندگینامه نقش فرد را در زمینه اجتماعی و علمی مرتبط با موضوع «کاربرد مدل احتمالاتی و AI در علوم زیستی و یادگیری آنلاین» توضیح میدهد.
نقش همکاری و ساخت تیم
در پژوهش و توسعه هوش مصنوعی، حتی ایدهای که به نام یک فرد شناخته میشود به داده، همکار، زیرساخت محاسباتی و سالها آزمون وابسته است. Daphne Koller را باید در این زمینه دید. نتیجه موفق آزمایشگاهی بدون تیمی که کد را قابل بازتولید کند، لزوماً به ابزار عمومی تبدیل نمیشود. برعکس، طراحی زیرساخت بدون پرسش علمی روشن نیز ممکن است هزینهزا باشد. زاویه «کاربرد مدل احتمالاتی و AI در علوم زیستی و یادگیری آنلاین» نشان میدهد پیشرفت معمولاً از تعامل چند مهارت به دست میآید. هنگام بیان نقشها، عنوان همبنیانگذار یا نویسنده مقاله باید با منبع رسمی تطبیق داده شود.
آثار و ایدههای اثرگذار
اهمیت Daphne Koller فقط به حضور در خبرهای شرکتهای بزرگ محدود نیست؛ ایدهها و روشهای مورد توجه او بر ابزارهایی تأثیر گذاشتهاند که توسعهدهندگان امروز استفاده میکنند. برای بررسی این اثر بهتر است ابتدا مقالههای علمی، کد منتشرشده یا توضیح رسمی گروههای پژوهشی مطالعه شود و سپس نتیجه آنها با مثال عملی مقایسه گردد. موضوع «کاربرد مدل احتمالاتی و AI در علوم زیستی و یادگیری آنلاین» میتواند پلی میان نظریه و کار مهندسی باشد، اما لازم نیست هر ایده را به آیندهای قطعی وصل کنیم. یک کار علمی خوب ممکن است سالها بعد در زمینهای بسیار متفاوت به کار گرفته شود.
تفاوت شهرت و اعتبار علمی
شبکههای اجتماعی گاهی افراد مشهور فناوری را به نماد یک پیشرفت پیچیده تبدیل میکنند. درباره Daphne Koller نیز باید تمایز میان نقش واقعی، تفسیر رسانهای و روایت تبلیغاتی را حفظ کرد. اعتبار علمی معمولاً با کیفیت پژوهش، امکان بازتولید، ارجاعهای معتبر و مشارکت جامعه سنجیده میشود؛ محبوبیت آنلاین معیار مستقلی نیست. اگر دیدگاهی درباره آینده هوش مصنوعی مطرح شده باشد باید به صاحب آن نسبت داده شود، نه اینکه نتیجه قطعی علم معرفی گردد. زندگینامه فنی زمانی ارزشمند است که خواننده پس از آن بفهمد دقیقاً چه مسئلهای حل شده و چه بخشهایی هنوز بحثبرانگیزند.
آنچه توسعهدهندگان میتوانند بیاموزند
یک درس کاربردی از مسیر Daphne Koller آن است که پیشرفت در فناوری پیچیده به ترکیب مطالعه عمیق و ساخت نمونه آزمایشی نیاز دارد. سناریوی «تحلیل داده زیستی با مجموعه آموزش محدود و اعتبارسنجی مستقل» میتواند تمرین مناسبی برای فهم قسمتی از این مسیر باشد، به شرط آنکه از ادعای بازتولید همه دستاوردهای فرد پرهیز شود. دانشجویان میتوانند یک مقاله پایه را انتخاب کنند، فرضیههای آن را در اندازه کوچک بیازمایند و محدودیت نتیجه را بنویسند. این فرایند از حفظکردن نام مدل و شرکت مفیدتر است و پایهای برای تصمیم مستقل در پروژههای آینده ایجاد میکند.
بحثهای باز و مسئولیت اجتماعی
فناوریهایی که به نام پژوهشگران مطرح میشوند، آثار اقتصادی و اجتماعی گستردهای دارند. پرسش درباره «برداشت اغراقآمیز از پیشبینی مدل بهعنوان نتیجه قطعی آزمایش بالینی» نمونهای از موضوعاتی است که نمیتوان آن را تنها با افزایش دقت مدل یا سرعت پردازنده حل کرد. آثار بر کاربران، کارکنان و گروههای مختلف باید با شواهد بررسی شود. دیدگاه شخصی Daphne Koller در این زمینه مهم است اما نباید بدون منبع به او نسبت داده شود. پژوهش مسئولانه همچنین مستلزم پذیرش عدم قطعیت، مستندسازی محدودیتها و توجه به شرایطی است که مدل یا محصول خارج از محیط آزمایش دچار مشکل میشود.
مسیر مطالعه آثار شخص
برای مطالعه بیشتر درباره Daphne Koller بهتر است از وبسایت شخصی، مقالههای دانشگاهی و صفحات رسمی سازمانهایی شروع کنیم که نقش حرفهای او در آنها ثبت شده است. منابع ثانویه میتوانند زمینه تاریخی ارائه کنند اما در تاریخها و انتساب ایدهها گاهی اشتباه دارند. پس از گردآوری چند منبع، یک خط زمانی ساده از پروژهها و انتشارها بسازید و بین مشارکت در ایده، مدیریت تیم و عرضه محصول تمایز بگذارید. به این شکل حتی اگر سمت سازمانی فرد تغییر کند، تحلیل بنیادی زندگینامه همچنان قابل استفاده خواهد بود.
مفهوم فنی پشت موضوع
برای فهم دقیق Daphne Koller باید میان نام تجاری یا عنوان خبر و سازوکار فنی پشت آن فاصله گذاشت. در این پرونده محور اصلی «کاربرد مدل احتمالاتی و AI در علوم زیستی و یادگیری آنلاین» است و همین محور نشان میدهد چرا یک نتیجه قابل مشاهده همیشه همه واقعیت معماری را بازگو نمیکند. لایه داده، نرمافزار، دسترسی و زیرساخت بر یکدیگر اثر میگذارند و تغییر در یکی از آنها ممکن است رفتار نهایی را تغییر دهد. هنگام بررسی چنین موضوعی باید مرز آنچه منبع اصلی تأیید کرده با آنچه صرفاً تحلیل مهندسی محسوب میشود معلوم باشد. اگر سند رسمی درباره نسخه یا ویژگی سکوت کرده است، سکوت آن را نباید با ادعای قطعی جایگزین کرد.
سناریوی مشخص برای فهم مسئله
سناریوی «تحلیل داده زیستی با مجموعه آموزش محدود و اعتبارسنجی مستقل» را در نظر بگیریم. قبل از اجرای پروژه یا نتیجهگیری از این مثال، باید مالک سرویس، کاربران مجاز، محیط آزمایش و معیار موفقیت معلوم شوند. قدم اول ایجاد یک وضعیت پایه است؛ سپس تنها یک متغیر را تغییر میدهیم تا رابطه علت و نتیجه قابل مشاهده بماند. اگر نتیجه دلخواه حاصل نشد، ثبت گزارش اجرای واقعی از حدسزدن درباره علت مفیدتر است. همچنین قرار دادن داده نمونه به جای داده تولید، ریسک دسترسی غیرضروری را کاهش میدهد. هدف چنین سناریویی آموزش تفکر روشمند است، نه ادعای اجرای موفق آزمونی که هنوز انجام نشده است.
تصمیمهای معماری و وابستگیها
در طراحی مرتبط با Daphne Koller لازم است وابستگیهای مستقیم و غیرمستقیم جدا شوند. وابستگی مستقیم ممکن است یک API، نرمافزار، تراشه، گواهی یا سرویس شبکه باشد. وابستگی غیرمستقیم میتواند سیاست سازمان، قرارداد تأمینکننده یا مهارت تیم نگهداری باشد. مسئله «کاربرد مدل احتمالاتی و AI در علوم زیستی و یادگیری آنلاین» معمولاً زمانی پیچیده میشود که یک مؤلفه در آزمایشگاه درست کار میکند ولی در محیط واقعی چند مالک یا چند مسیر متفاوت دارد. برای کاهش ابهام، معماری باید با شکل سادهای از مبدا داده، محل پردازش، تصمیم امنیتی و مقصد نتیجه مستند شود. هر نقطهای که امکان شکست مستقل دارد باید برنامه بازیابی مناسب داشته باشد.
ریسک و کنترلهای متناسب
مهمترین خطر قابل بررسی در این زمینه «برداشت اغراقآمیز از پیشبینی مدل بهعنوان نتیجه قطعی آزمایش بالینی» است. واکنش مناسب نه نادیدهگرفتن خطر است و نه خاموشکردن فوری همه قابلیتها بدون شناخت وابستگیها. ابتدا باید مشخص شود چه داراییهایی در معرض آن هستند، مهاجم یا خطای انسانی چه پیششرطهایی نیاز دارد و چه شواهدی برای سنجش وجود دارد. پس از آن، کنترلهایی مانند کاهش سطح دسترسی، پایش، جداسازی شبکه و بهروزرسانی را میتوان متناسب با مسئله انتخاب کرد. در یک محیط حیاتی، هر کنترل جدید باید از نظر تأثیر بر خدمات مجاز بررسی شود تا راهکار امنیتی خودش منشأ اختلال نشود.
اصول پیادهسازی و تغییر کنترلشده
پیشنهاد عملی برای این موضوع «تفکیک مقاله دانشگاهی، نتیجه آزمایشگاهی و کاربرد تجاری تاییدشده» است. بهتر است این کار با محیط کنترلشده شروع شود و پس از مشخصشدن نتیجه به تعداد محدودی از کاربران یا دستگاهها گسترش یابد. هر تغییر مهم باید نام مسئول، پنجره اجرا، نسخه قبلی، امکان بازگشت و آزمون سلامت داشته باشد. در زیرساختهای حساس، ثبت نتیجه پیش و پس از تغییر برای اثبات اثر واقعی ضروری است. اگر شرط لازم برای اجرا مانند مجوز، قرارداد، ظرفیت حافظه یا دسترسی سرویس مهیا نیست، بهتر است پروژه به همان وضعیت آزمایشی محدود شود تا تصمیم بزرگ بر پایه داده ناکافی گرفته نشود.
پایش و مشاهدهپذیری
بدون مشاهدهپذیری، استفاده از Daphne Koller پس از مدتی به مجموعهای از حدسها تبدیل میشود. حتی اگر عملکرد اولیه مناسب باشد، رشد داده، تغییر نسخه یا افزایش کاربران میتواند رفتار را عوض کند. شاخصهای مناسب ممکن است زمان پاسخ، نرخ خطا، میزان دسترسی ناموفق، هزینه منابع یا تعداد رخدادهای قابل اقدام باشند؛ باید از بین آنها موارد مرتبط با «کاربرد مدل احتمالاتی و AI در علوم زیستی و یادگیری آنلاین» انتخاب شوند. نمودارها باید با زمان مشترک و نسخه ثابت تحلیل شوند و اطلاعات حساس را بیش از ضرورت جمع نکنند. هدف از پایش، ایجاد هشدارهای فراوان نیست؛ باید مشخص کند چه زمانی لازم است مسئول فنی واقعاً اقدامی انجام دهد.
حریم خصوصی و مسئولیت داده
هر طرح عملی مرتبط با Daphne Koller ممکن است داده کاربر، شناسه دستگاه، مسیر شبکه یا نتایج عملیاتی را پردازش کند. قبل از گردآوری باید روشن باشد کدام داده ضروری است، چه کسی به آن دسترسی دارد و چه زمانی حذف میشود. حتی دادههایی که در نگاه اول فنی به نظر میرسند، ممکن است با اتصال به لاگ دیگر هویت اشخاص را آشکار کنند. برای سناریوی «تحلیل داده زیستی با مجموعه آموزش محدود و اعتبارسنجی مستقل» لازم است اطلاعات محرمانه با نمونههای ساختگی جایگزین شود و دسترسی موقت پس از پایان آزمایش لغو گردد. ثبت رضایت یا مبنای قانونی پردازش نیز در محیطهای دارای مقررات مربوطه اهمیت دارد.